这篇文章把MS2CAST放回它所属的研究路线:先看下一帧预测为何被用于异常检测,再辨认时序模块的来源,最后讨论系统选型、噪声证据与在线边界。这里区分论文事实与我的判断,不把某个配置的优势写成普遍结论。
一、先给论文定位,而不是先列模块名称
MS2CAST以正常视频训练下一帧预测:四帧经过冻结的MViTv2-S与ConvNeXt-T、多尺度交叉注意力,低分辨率特征进入SwinLSTM或VMRNN,其余经跳连辅助解码。Q来自前一分支,K/V来自后一分支;Pre-LN规范注意力输入,残差保留原Q。评分在视频内归一化预测误差并平滑。MS2CAST,§3
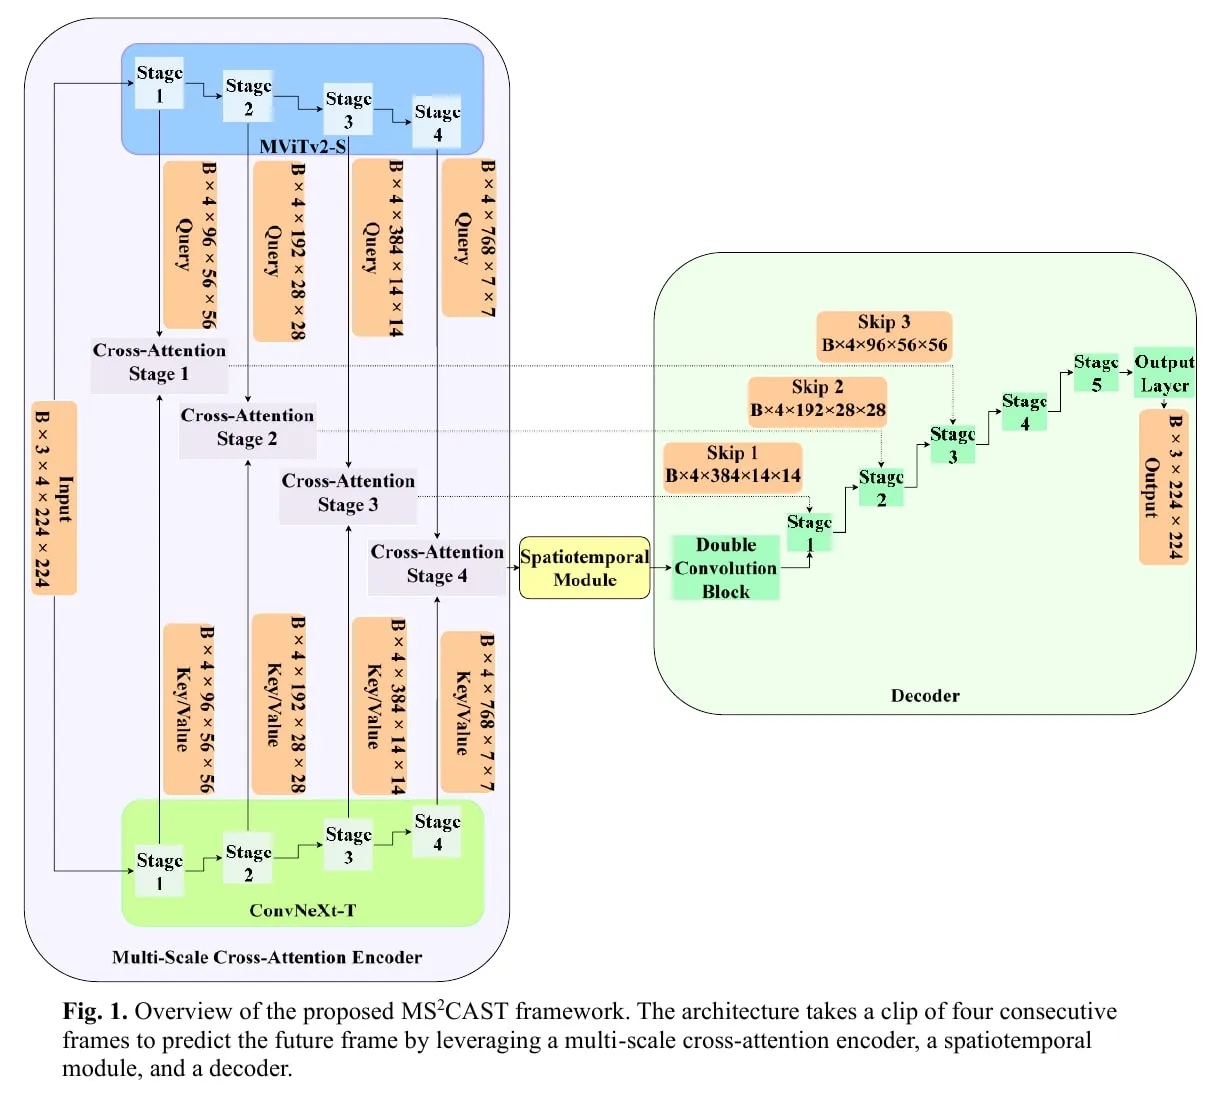
图1,Safaei与Kazemi,MS2CAST,PDF第9页。节选用于对应方法评论,版权归原权利人。
我的阅读顺序是沿数据经过的接口追问:空间表征交给时间模块的是什么,时间模块实际改变了什么,最后的检测决定又由谁作出。这样可以防止把“预测网络”和“异常检测系统”当成同一个对象。网络产生的误差,仍要经过评分规则才能成为检测结果;评价整个系统时,不能只赞扬中间最醒目的模块。
二、与早期预测基线相比,研究问题并没有消失
Liu等在CVPR 2018的预测基线中,已经用未来帧与真实帧的差异进行检测,并同时约束像素、梯度和运动一致性。它的出发点是:仅重建输入,并不能自然保证异常具有更大误差。因此,“用预测误差检测异常”应视作这条路线的既有思想,而不是新论文仅凭名称就能占有的贡献。Future Frame Prediction
由此引出的关键问题,比“预测画面是否清晰”更尖锐:改进预测器时,正常和异常两类误差分别怎样改变?假设两个模型都把正常误差降了一半,其中一个也同样擅长预测异常,检测排序就不一定改善。这是一个关于目标错位的逻辑例子,并非论文中的测量。
因此,我会把复现验收分成两栏:一栏记录预测质量,另一栏记录检测区分度。不能用前者的改进代替后者的证明,也不能只凭最终检测分数倒推出预测器学会了哪一种正常性。这里真正要解释的是两项任务怎样连接,而不是再加一段损失函数百科。
三、为什么需要回到SwinLSTM和VMRNN的原始论文?
SwinLSTM将Swin Transformer块与简化LSTM结合,目的在于改进时空预测;其原始实验涉及Moving MNIST、Human3.6m、TaxiBJ、KTH等预测任务。它并不是为异常分数设计的新判别器。阅读MS2CAST时,应把它看作被引入系统的时空建模构件,而不是将它的全部能力算成新框架的原创。SwinLSTM
VMRNN则把Vision Mamba块与LSTM结合,同样面向时空预测;原论文强调较小模型规模下的竞争性结果。它提供的是另一种空间信息处理与递归状态更新的组合,不能仅因名字含Mamba,就预先断言放入任何完整系统都会更快、更省显存。VMRNN
这两篇原始工作的价值,在于把比较对象说准确:我们比较的是两种既有预测构件在新检测系统中的适配性,不是在裁决“Transformer与Mamba谁永远更好”。速度还会受输入尺度、实现、并行方式和前后端影响;原始论文的优势不能不加条件地搬到另一套流水线上。
我更希望看到可替换接口被明确固定:保持输入输出约束、训练预算和评分规则一致,再替换时间模块。否则,换模块时顺带改掉表示维度或训练策略,最终差异就不再是一个干净的问题。这个建议针对比较实验的可解释性,并非声称作者没有做过相关控制。
四、主结果、组件对照和噪声实验,不能互相顶替
MS2CAST选定配置的Ped2/Avenue/ShanghaiTech帧级AUC为96.1/85.8/75.3。组件表中Ped2的Pre-LN+VMRNN达到96.5;选定SwinLSTM因此不等于每项指标夺冠。固定SwinLSTM时,Avenue在强噪声下偏向Pre-LN,而Ped2存在反例。原文表3、5、6、8
我的判断是,选型应被读成多目标取舍:总体表现、特定扰动下的稳定性,以及运行成本不必由同一配置同时最优。主结果负责展示完整系统的表现;组件对照负责缩小贡献来源;噪声实验负责限定某种扰动条件下的结论。拿其中任意一项替代其余两项,都会把证据范围扩大。
尤其应避免一句“加入模块后提高,证明模块有效”就结束分析。更有解释力的做法是核对这个变化在哪个组合出现、是否跨场景保留、是否牺牲其他目标,以及评分设置是否保持一致。否则,我们得到的只是一个获胜配置,而不是对设计选择的理解。
五、结构图怎样读到机制,而不是读成性能保证?
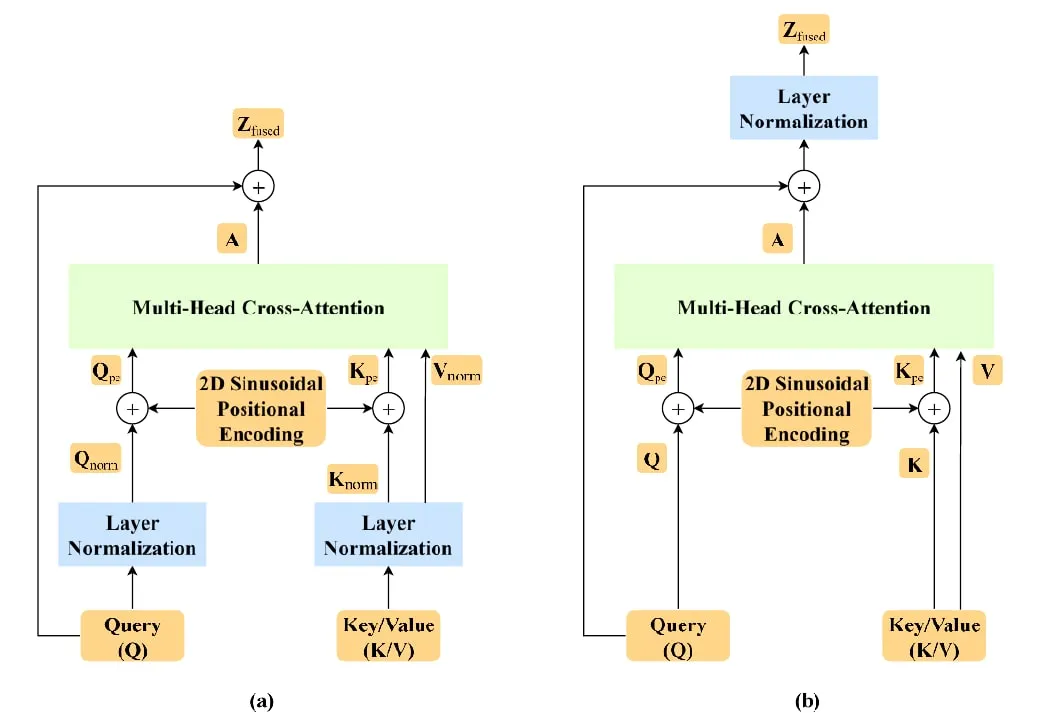
图2,Safaei与Kazemi,MS2CAST,PDF第13页。节选用于对应机制评论,版权归原权利人。
读这张图时,我会先区分受某个操作影响的路径与绕过它的路径,再讨论可能的解释。这样做不是为了把结构图写成逐箭头说明书,而是防止从局部操作推导整个输出已经获得某种性质。
例如,“参与匹配的表示得到规范”与“最终融合特征已经去噪”不是同等强度的判断。后者需要额外观察中间表示或设计相应控制。最终AUC可以说明系统在某种评测中表现如何,却不能单独确定内部哪条机制是原因。分析到这里,应保留可检验的解释,而不是替作者补上一段没有实验支撑的因果故事。
六、效率与在线性,要回到完整系统的边界
原文表7的显存是推理测量,不是训练预算;评分定义使用整段视频的范围,因此不能直接把离线流程当成严格在线报警。原文§3.6、表7
这意味着部署验收至少有两份清单:一份测定从输入到输出实际需要的资源,另一份检查输出在当前时刻是否已经可计算。前一项再快,也不能自动消除后一项的信息等待。把“每秒处理多少帧”与“报警依赖哪些已到达数据”分开,才不会把计算性能和信息条件混成一句“实时”。
如果继续复现,我会先保留原评测以确认实现一致,再单独替换评分校准和时间处理,记录改动前后的事件发现时刻。两份结果必须分别命名,不能一边更换部署协议,一边声称严格复现了原表格。这是我建议的验证顺序,而不是论文尚未完成事项的清单。
七、我的结论
MS2CAST值得讨论的,是怎样组合表征、时序预测与检测评分,以及组合后承担了哪些新的验证责任。阅读后的收获不应只剩一个最优配置:要能说清哪些构件来自已有研究,哪类实验支持哪种选择,哪些工程判断仍需独立验证。把这些连接讲清楚,比把模块名字或排行榜抄得更完整,更接近可用的研究理解。
参考文献
1.MS2CAST,arXiv:2610.29649v1。 2.Future Frame Prediction,arXiv:1712.09867v3。 3.SwinLSTM,arXiv:2308.09891v2。 4.VMRNN,arXiv:2403.16536v3。