Cerberus 精读:97.2%不是准确率,151倍加速成立在哪里?
阅读版本:arXiv:2510.16290v1,2025年10月18日。本文依据完整正文、实验表格及必要的 AnomalyRuler 方法对照。论文采用 CC BY 4.0;以下区分作者报告、直接计算与工程推断。这里讨论的是视频异常检测,不是语音活动检测。
一、真正的问题:为什么每帧都要请“大模型专家”?
监控视频的大多数时间没有异常,但让视觉语言模型逐帧描述,再让语言模型判断是否违反规则,会把大量计算花在重复正常场景上。Cerberus 的问题不是如何让一个更大的模型包办一切,而是如何让便宜的筛查负责大多数输入,只把疑似异常交给昂贵模块。
这个问题值得做,但首先应拆开摘要中的两个醒目数字。论文报告的约97.2%是相对于 AnomalyRuler 的 AUC 保留比例,不是97.2%的分类准确率。平均约151.79倍吞吐提升则来自异常帧占比被调整为1%的实验组,不能理解为所有视频都获得相同加速。
系统还需要目标场景的正常参考视频来形成规则,并允许人工补充领域知识。因此,“无需额外梯度训练”可以成立,“不需要目标域信息”却不成立。它更接近用现成模型搭建可配置的正常性规则引擎。
二、离线规则:正常样本不是训练标签,却仍是知识来源
作者让 Qwen2.5-VL-7B 描述正常视频中连续的若干帧,关注运动主体、动作和场景上下文,再由 DeepSeek-R1-0528 概括反复出现的正常模式。这样的两步分工避免直接把每条冗长描述都当规则:前者提供视觉观察,后者负责归纳。
正常规则之外,系统还引入 Moments in Time 的339个原子动作标签作为扰动对照,构成候选池。这里不能把339个动作写成“覆盖全部异常的知识库”。一个动作是否异常依赖地点、时间与关系,同样是奔跑,在操场和受限制区域可能有不同含义。这些动作主要为语义比较提供反差,不是开放世界完备性证明。
用户也能补规则,例如场景中特定行走方向或逗留行为是否允许。它给系统增加可解释的配置入口,同时把一部分成功条件转移给了参考片段质量与规则编写者。正常视频如果没有覆盖合法但罕见的活动,系统仍可能把它们误报。
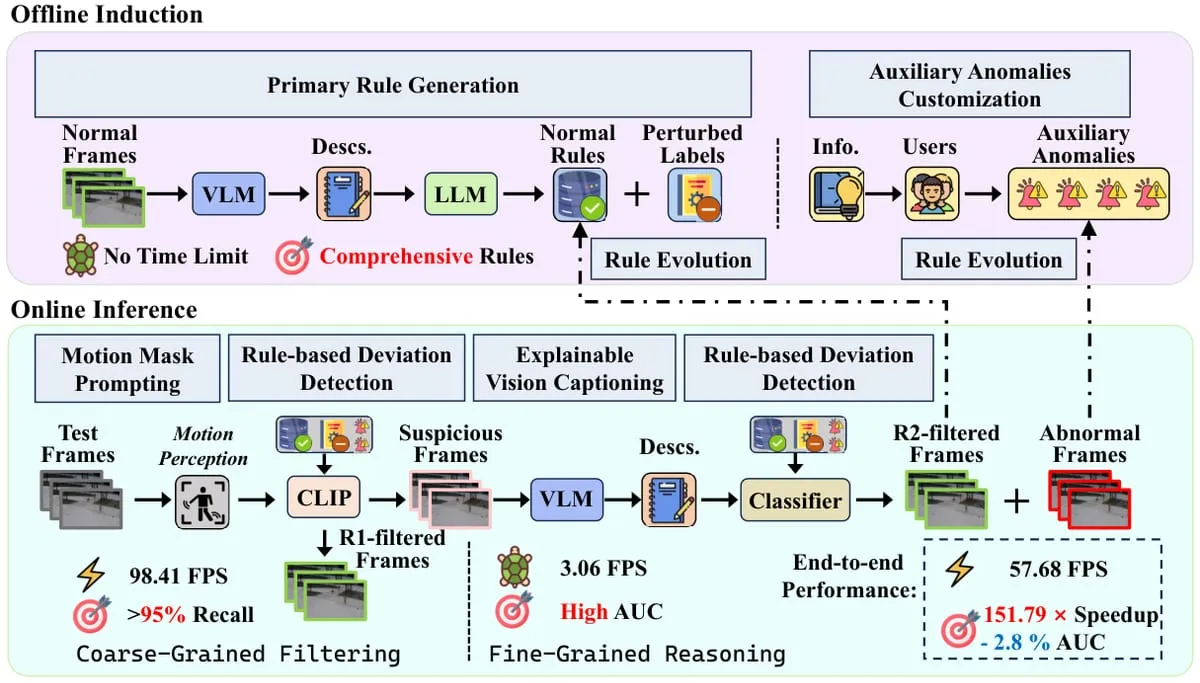
图注:图1|原论文 Figure 5:离线正常规则与在线粗细级联。Yue Zheng 等,CC BY 4.0,原图。(来源:论文)
三、在线级联:便宜的门卫决定专家能看见什么
第一道筛查利用相邻帧像素变化。当运动信号低于阈值时,帧被跳过;有运动时,再按强弱叠加不同视觉提示:较细微运动用红圈,较明显运动用红方框。作者的直觉是圈更有利于保留小目标线索,框更有利于抑制背景干扰。这不是对象检测的真值框,也不应被当成异常定位标注。
随后,PE-Core-L14-336 提取图像及规则文本表示,比较余弦相似度。系统取最相关的五条候选,根据它们属于正常规则还是扰动规则赋予正负权重,形成健康度分数。低于阈值的输入才进入细粒度阶段。
这使粗筛具有双重职责:降低昂贵调用量,同时尽可能保住异常召回。论文用粗筛召回超过95%约束筛选强度,但这不是整个系统的最终召回率承诺。被第一阶段丢弃的异常,后面的专家无从补救;保留下来的异常,也可能被第二阶段误判。
细粒度模块并非直接让大模型给出一个不可分解的最终答案。Qwen 视觉语言模型先生成描述,Qwen3-Embedding-4B 再把描述与规则映射到同一文本向量空间,继续进行健康度比较。它把跨模态图文匹配转成文本间匹配,试图减少语义错位;但视觉描述漏掉关键动作时,嵌入模型不能恢复没有写出的事实。
级联的吞吐逻辑可概括为每帧平均成本约等于粗筛成本加上“进入细筛的比例×细筛成本”。因此真正控制收益的是可疑帧比例,而不只是模型大小。人流密集、持续剧烈运动或镜头抖动,都可能让更多输入进入昂贵分支;这是从结构推导出的部署风险,不是论文已经测出的失败率。
从相邻方法看,AnomalyRuler 的核心也不是把几个异常词硬塞给模型:它通过正常片段诱导规则,再在推断阶段结合描述、平滑和重新检查。Cerberus 的主要变化是提前过滤输入,并用文本嵌入匹配承担细筛中的判别工作。因而公平问题不是“有规则对无规则”,而是相似知识条件下,增加门控能节省多少调用、损失多少证据。
视频任务还存在时间语义的缺口。像素差分利用相邻帧,但有运动不代表异常,局部静止也不代表正常;持续遗留物体、动作顺序违例和缓慢发生的事件,都可能需要比单次候选判断更长的上下文。现有结果不能自动证明模型完整理解了这些时间关系。论文的实时性也主要由吞吐和总耗时体现,尚不能据此承诺从事件开始到发出通知的严格时限。
四、反馈更新:规则会变好,也可能积累错误
系统设计了两类反馈。F2C 把细筛确认正常的样本反馈给规则生成阶段,让粗筛以后少打扰专家;UIL 则利用用户确认的异常补充异常侧知识。前者主要提高效率,后者为场景特定异常增加证据。
这一机制与普通离线模型不同:它改变的是规则资产,而非重新训练所有参数。然而,确认正常并不等于事实正常。若细筛误判后自动更新,错误可能被固化为新正常规则。发布前保留规则版本、审核高影响更新、允许回滚,是合理工程建议,论文没有证明这些防护已经实现。
反馈实验也不是长期真实用户研究。作者随机把数据分成两半,在一半执行推断及更新,再在另一半评估,重复三种随机划分;其中 Qwen-VL-Max 模拟用户定制。这个设计能检验更新后是否迁移到另一部分数据,却不能证明真实部署数月后面对概念漂移仍稳定。
规则池是这套系统的重要可审计接口,但自然语言“可读”与决策“可信”仍是两回事。健康度由近邻相似度和符号权重聚合得到,并非每条规则都经过逻辑验证;近义词、动作主体混淆和背景语义都可能改变近邻排序。实用的日志应同时保存触发帧、视觉描述、命中的规则及分数,而不是只显示一句模型结论。这样才能区分视觉观察错了、规则写窄了,还是阈值设置不合适。以上是复现与审计建议,不属于原文已经完成的可靠性保证。
五、主表怎样读:原始分布与1%异常不是同一个故事
实验使用 L40S GPU、Xeon 处理器和64GB内存,比较 Avenue、ShanghaiTech、UBnormal 与 Campus。作者对基线统一配置视觉语言模型及相关规则条件,所以这里的 AnomalyRuler 是对照实现,不宜与它原论文不同模型配置下的公开成绩直接混排。
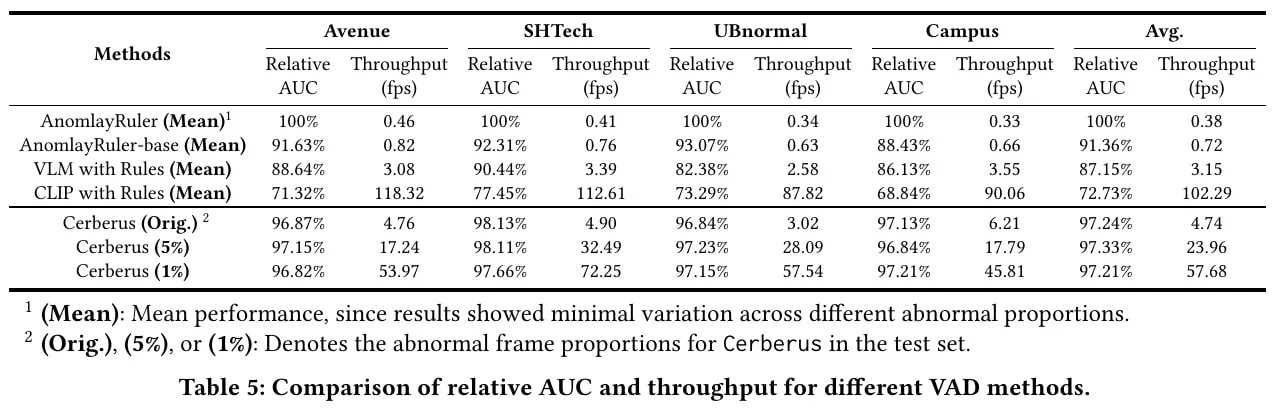
图注:图2|原论文 Table 5:相对 AUC 与吞吐,100%只是以 AnomalyRuler 为基准。Yue Zheng 等,CC BY 4.0,裁切。(第 9 页,来源:论文)
表5把 AnomalyRuler 的 AUC 设为100%参考。原始分布下,Cerberus 平均保留97.24%的参考 AUC,吞吐4.74 fps,对照为0.38 fps;直接相除约12.47倍。异常占比5%时是97.33%与23.96 fps;1%时是97.21%与57.68 fps,才对应约151.79倍。
这些异常比例较低的组,是通过分层复制正常帧构造的。它确实能回答正常输入更多时,级联的平均计算成本如何变化;但重复正常帧不会自动创造新场景、罕见合法动作或长时漂移。因此它是条件性负载实验,不是独立真实环境测试。
更要警惕“参考100%”的语言陷阱:它只是分母归一化,绝不意味着基线无误判。论文正文某处把100%相对 AUC 描述成完美准确性,读者应以指标定义纠正这一表述。AUC 衡量排序,不能直接给出一个固定报警阈值下的漏报率、误报次数或响应延迟。
六、消融揭示了什么代价?
表8在 ShanghaiTech 的10%帧子集上比较两个阶段。原始组仅粗筛 AUC67.85,耗时0.01小时;仅细筛84.24、0.35小时;级联82.73、0.23小时。级联相对细筛损失1.51个百分点,换取计算下降,并不是精度与速度同时免费提升。
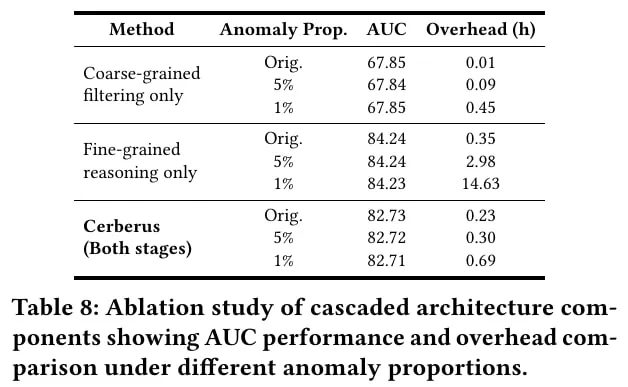
图注:图3|原论文 Table 8:ShanghaiTech 子集上的阶段消融;与主表不是相同基线口径。Yue Zheng 等,CC BY 4.0,裁切。(第 11 页,来源:论文)
1%异常构造组中,仅细筛耗时14.63小时,级联0.69小时,AUC 分别84.23与82.71。这一比较约为21.20倍加速,与主表151.79倍并不冲突:基线、数据子集和度量口径不同。把它们混为一个统一速度优势,会丢失实验含义。
规则生成消融同样重要。表6基准 AUC82.73,去掉动作信息下降18.56个百分点,去掉上下文下降6.13,去掉归纳步骤下降14.92。最后一种情况下规则数量反而增加,说明更多描述不等于更好的正常性边界。作者报告三次平均,但没有因此获得足以量化稳定性的完整置信区间。
更接近报警体验的是表9:ShanghaiTech 的端到端召回为48.24%,Campus为40.97%。它们与粗筛超过95%的召回不是同一指标。读者若只看主表的高比例 AUC,就会错过系统在所用决策设置下仍可能漏掉大量异常的事实。
七、证据边界与复现检查点
有一处应显式保留的原文冲突:领域定制实验表7给出 ShanghaiTech AUC 增益1.82个百分点,正文却写3.82。本文采用表格数字,不替作者猜测哪个版本才是最终意图。运动阈值的敏感性实验又使用子集,其最优91.93 AUC也不能替换主实验的82.73。
作者承认根本性的概念漂移仍困难,例如限制区域变为公共空间。除此之外,静止异常可能被运动门控漏掉、规则更新可能传播模型错误、平均吞吐不能代表尾延迟,都是本文从设计推导的限制,不能写成作者已验证的失败结论。论文也没有提供足够证据,让读者把服务器 GPU 的结果等同于普通摄像头端实时能力。
若复现,应固定正常参考集、候选规则版本和人工知识输入,分别记录粗筛及端到端召回,报告正常帧是否重复构造,按原始分布测吞吐及报警延迟,并把阈值选择集与最终测试集分开。比较 AnomalyRuler 时还应说明替换了哪些模型,否则不能归因于级联本身。
Cerberus 的价值不在“97.2%准确率的万能监控”,而在展示一种有条件的计算分配方案:当正常输入占多数、粗筛可靠且规则可维护时,把大模型留给少数疑点可以显著省算力。真正部署前必须回答的仍是:被门卫挡掉的异常有多少,复杂场景下专家会被调用多频繁,以及错误反馈会不会变成下一轮的新规则。