DeCoS精读:视频找到了异常,却真的听懂你的异常定义了吗?
假设同一段视频先发生枪击,随后发生爆炸。当用户只关心枪击时,模型应突出前一段;换成爆炸定义,重点应随之移动。如果两次异常曲线几乎一样,即使它准确找到了两个危险时刻,也没有真正完成用户要求的条件化检测。
《Rethinking Open-World Video Anomaly Detection: Diagnosing Definition Blindness》将这种情况称为“定义盲”。本文基于 2026 年 7 月 22 日的 arXiv:2607.20780v1,阅读全文及附录 A—E。它最重要的贡献不是又提高了一个常规 AUC,而是追问:现有指标是否真的测到了语言定义对时间定位的控制能力?DeCoS 是作者提出的一个可训练修正,用来证明这个失败模式能够被改善。
一、为什么指标可能奖励一个不听指令的模型
传统异常检测将所有异常帧视为正例、正常帧视为负例。这适合测量有没有发现异常,却没有要求不同异常之间互相区分。因此,一个对任何输入文字都输出相同异常曲线的模型,依然可能取得不错的成绩。
动态定义评测看似更接近目标:本次指定的异常是正例,其他异常与正常帧都是负例。但作者给出一个精确分解:AUROC 等于“目标异常对正常帧”的排序质量,与“目标异常对其他异常”的排序质量,按负例数量比例加权。当前基准的正常帧很多,于是第二项可能被冲淡。
论文统计 XD、MSAD、UCF 的正常帧分别占该负例池的 87.9%、88.5%、96.4%。因此第一项得到约 7.2、7.7、26.8 倍的权重。模型即使忽略了用户排除的其他异常,只要善于区分异常与正常,也能在汇总指标上显得很强。这不是 AUROC 本身错误,而是评测对象与实际需求不一致。
这里不能把同样的线性分解直接用于 AP。附录推导说明,AP 的正常误报和其他异常误报共同进入精确率分母,不能简单相加。两种指标都可能隐藏条件化不足,但数学原因需要区分。
二、三个指标分别排除了什么捷径
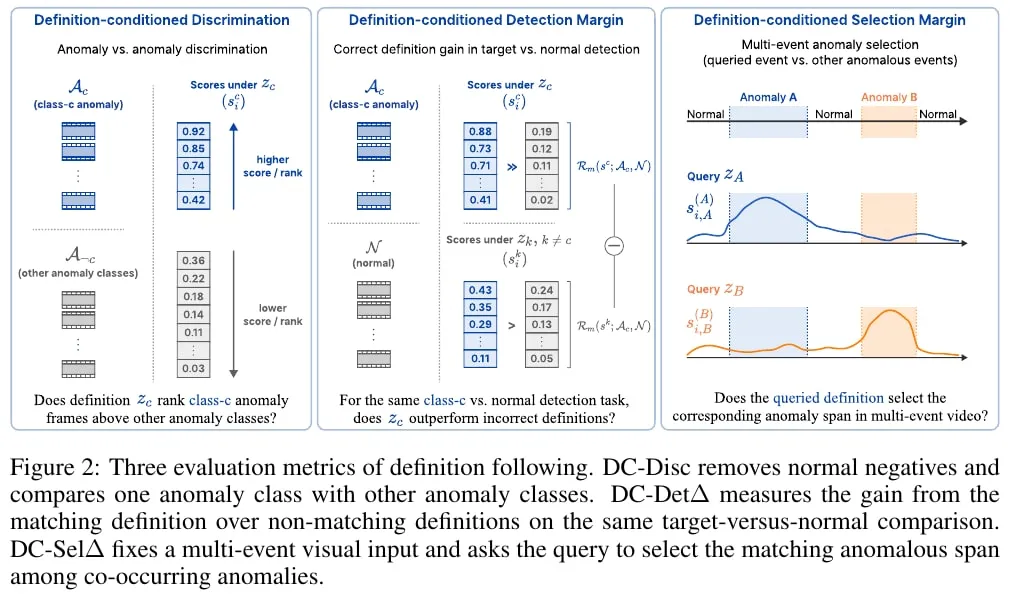
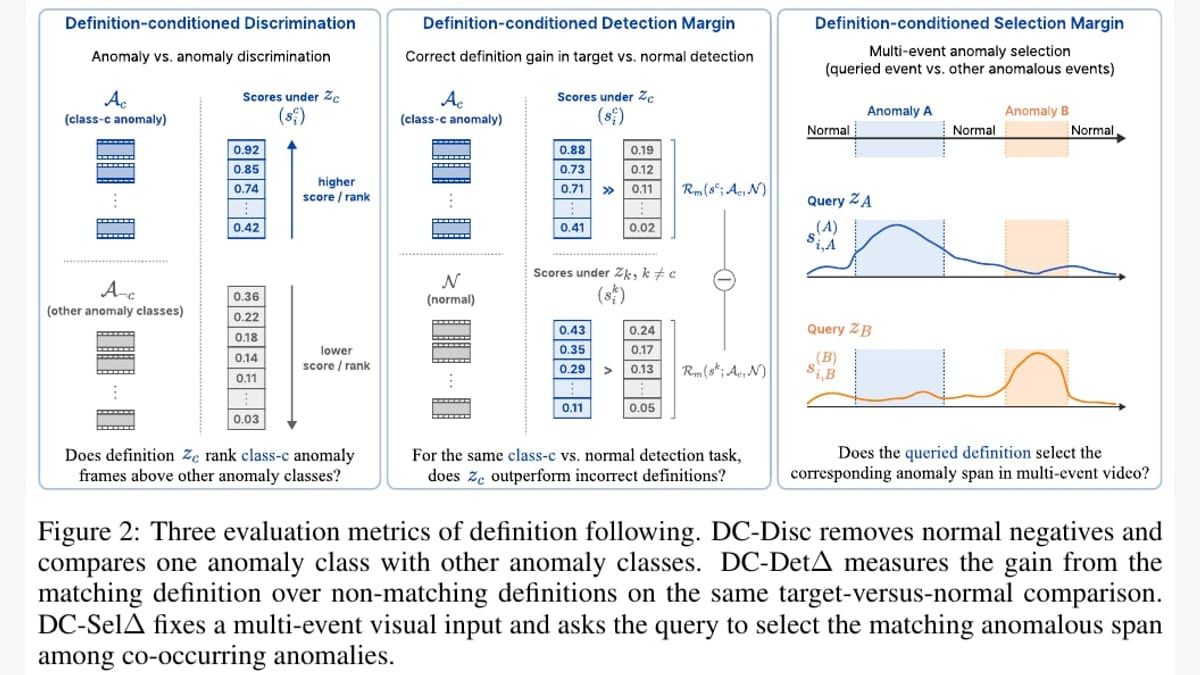
图注:图2:三个指标依次去除正常负例、查询无关评分与多事件选择捷径。Δ是指标差值。 来源:Song与Lee,DeCoS v1,CC BY 4.0。(按原页裁切。)(DECOS v1,CC BY 4.0,第 5 页,来源:论文)
DC-Disc 把正常帧拿掉,只比较目标异常与其他异常,按类别汇总。给所有危险事件一起打高分已经不够,目标必须排在非目标前面。但这个指标单独使用仍不完全等于因果干预:某个定义无关的曲线可能偶然更擅长某类事件,因此还需要下面的差值。
DC-DetΔ 固定目标异常帧与正常帧,比较正确定义下的表现,与错误定义下平均表现的差距。如果模型完全不使用定义,两次排序相同,差值就是零,即使普通异常检测非常准确也无济于事。它测的是“正确定义额外带来多少帮助”,不是通常意义的检测准确率。
DC-SelΔ 固定包含多个异常的同一视频,比较切换定义后是否选中对应异常段。正常片段可以保留为上下文,但不参与异常对异常的指标计算。作者一方面构造受控双事件拼接,另一方面用自然多事件视频验证,避免把结论只建立在跨视频类别识别上。
这三个探针逐步限制捷径,但也没有取代传统指标。一个模型可以很好区分两个异常,却漏掉大量异常与正常的边界。合理的系统报告应同时保留一般定位与定义跟随,而不是用新表格遮住原有检测能力。
三、DeCoS 的核心:不允许所有定义一起变高
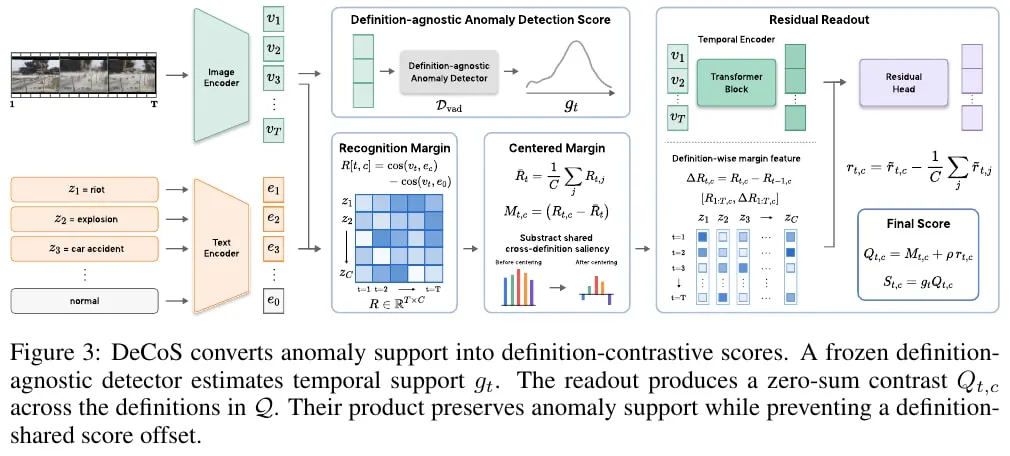
图注:图3:冻结异常支持与中心化定义证据相乘,时间残差学习具体定义选择。 来源:Song与Lee,DeCoS v1,CC BY 4.0。(按原页裁切。)(DECOS v1,CC BY 4.0,第 6 页,来源:论文)
DeCoS 保留一个冻结的、与定义无关的异常检测器,输出时间支持信号。它回答“这里像不像异常”,不接触文本。另一路用冻结 CLIP 编码视频帧和候选定义,计算每个定义相对正常描述的余弦相似度差。
但是,这个差值仍可能含有所有异常定义共享的危险感。例如浓烟、拥挤、剧烈运动,可能同时提高多个类别。因此作者在每个时间位置对候选异常定义做中心化:从各定义分数减去该时刻的跨定义均值。中心化后的总和为零,一个定义提高,必须相对其他定义体现出优势;共享的异常偏置被抵消。
接着加入一个有界的时间残差修正。视觉分支对所有定义共享,只运行一次;定义分支读取该定义的相似度差及时间一阶差分,使用共享时间编码器输出残差,再次进行跨定义中心化。最终把中心化证据与异常支持相乘。读出头零初始化,训练从冻结 CLIP 的中心化结果起步,而不是一开始任意覆盖其语义。
因此,它不是重新训练一个更强的异常检测器,而是学习如何把已有异常支持分配给具体定义。最终值可以为负,是用于排序的相对证据,不应直接解释成校准后的异常概率。候选集合也属于模型输入:换一批竞争定义,就可能改变均值和结果。
四、“零样本测试”不等于整个方法没有训练
附录明确,读出模块在 PreVAD 上训练,测试时不在 UCF、XD 或 MSAD 进行适配。每个训练样本包含事件描述和干扰定义,使用真实片段、单事件拼接、双事件拼接。事件位置由训练构造产生,继承视频级标签,作者说明没有额外人工逐帧标注。
损失只在构造的异常位置,对正确定义进行交叉熵选择;正常帧提供上下文,不进入该选择损失。由于冻结门控对所有定义相同,单纯提高“这里异常”的信号无法解决选择正确定义的问题。这使训练目标与诊断指标相呼应。
监督边界也由此清楚:这不是训练免费,更不是只靠一个减均值公式得到全部提升。读出头约 230 万可训练参数,另有冻结的约 650 万参数检测门控。两者合计约 880 万,不包含共享 CLIP 骨干。把 880 万当成全系统总参数,会低估实际模型成本。
内部正常参考还有一个必要细节:如果只给一个异常定义、又只在这一个定义内做中心化,分数必然变成零。单查询接口因此加入正常列作为对照,而不是直接套用多异常中心化。只有一个异常定义时,方法仍可运行,但对异常之间选择能力的检验更弱。
五、实验确实揭示了传统成绩看不到的差异
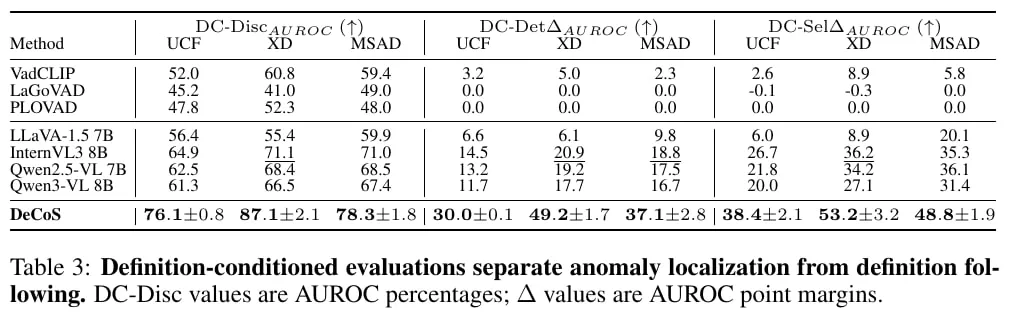
图注:表3:定义条件评测结果。DC-Disc为AUROC百分率,两个Δ列为AUROC点差,不能当普通准确率。 来源:Song与Lee,DeCoS v1,CC BY 4.0。(按原页裁切。)(DECOS v1,CC BY 4.0,第 7 页,来源:论文)
表 2 中,XD 的 LaGoVAD 在目标对正常的子指标为 90.3,目标对其他异常只有 55.4,汇总却仍为 85.9。DeCoS 对应为 90.6、87.4、90.1。目标对正常几乎没变,而真正需要条件化的部分明显提高。这正是论文想区分的两种能力。
表 3 的 DC-Disc AUROC 中,DeCoS 在 UCF、XD、MSAD 分别是 76.1、87.1、78.3;InternVL3 为 64.9、71.1、71.0。DC-DetΔ 则分别是 30.0、49.2、37.1 个 AUROC 点,而 InternVL3 为 14.5、20.9、18.8。这里差值的单位是百分点式的指标差,不是普通 AUROC 百分率,更不是“准确率提高了相同百分比”。
LaGoVAD 的差值接近零,而 PLOVAD 评测时本来就把同一条定义无关曲线复制给不同定义,因此为零是接口结构的直接结果,不能说实验突然发现它具有一个未宣称的语言能力缺陷。论文对照测的是这些具体输出接口的定义跟随,不等于宣判整个模型在所有任务上无效。
通用视觉语言模型基线同样有明确限制:附录使用逐采样帧、逐定义的统一数字评分提示,解析失败设为零。这是受控且容易复现的接口,但未必发挥多帧视频推理、工具调用或复杂提示的全部能力。新方法的优势应限定在该实验方案,不能扩展成比任何大模型系统都更理解视频。
六、真实视频、去类别名与未见事件控制
受控拼接使用真实异常片段,丢弃过短片段,较长片段裁成固定特征长度,并交换事件顺序。测试时固定四个填充定义,只改变目标定义。自然 XD 检查只有 43 段具有可分离标注区间的多事件视频,DeCoS 的 DC-SelΔ 为 34.1±5.8,VadCLIP 为 19.2。它减轻了“只学会拼接伪影”的担忧,但样本小且不均衡,作者也没有把它作为主要大规模基准。
去类别名实验将类别替换为三种具体视觉描述,另外将这些描述错误分配给类别作为对照。DeCoS 在正确描述下保留较大收益,打乱后明显下降,支持它使用了语义,而不只是遇到任何异常词都激活。不过,描述本身由模型生成,并不涵盖真实用户定义的全部表达变化、否定、组合条件或政策例外。
“未见事件”也需要仔细限定。附录承认未见名称未必是完全未见概念,例如 Fighting 与训练中的 assault/violence 接近。UCF 中较严格的新概念包括 Arrest、Burglary、Shoplifting、Stealing。因而这一控制更准确地支持部分词汇与概念迁移,而不是无限开放世界理解。
七、看完整附录后,需要收窄哪些结论
XD 消融中去掉残差使 DC-Disc 从 87.1 降到 76.7,去掉多事件训练使 DC-SelΔ 从 53.2 降到 35.5,支持时间修正与选择训练各有作用。但完整附录中,UCF 去掉残差的选择差值为 40.7,反而高于完整模型的 38.4。组件并非所有指标上都必须提高,正文的概括不能代替逐数据集结果。
AP 结果也不支持简单宣称全指标第一。MSAD 的 DC-DetΔ AP 中,InternVL3 为 29.8,DeCoS 为 25.2。AUROC 与 AP 对排序和类别比例的敏感性不同;新指标的优势必须注明使用了哪一种底层度量。
候选定义数量实验没有严格单调性。XD 五类对照的 DC-Disc 为 89.4,完整六类为 87.1;UCF 八类为 76.7,完整十三类为 76.1。更多对照通常有帮助,但也可能引入语义近邻干扰。这提醒部署者:系统不是只由目标句子决定,也依赖竞争集合如何构造。
八、效率与实际使用边界
论文在中位长度 MSAD 视频上重复二十次测量,报告后 CLIP 评分约十毫秒,含共享特征提取的完整流程约三十四毫秒。表中 PLOVAD 同样为三十四毫秒,因此准确说法是并列该表最低时延,而不是独占最快。该数字既不是任意长度视频的固定耗时,也不是无需计算 CLIP 的免费评分。
方法使用时间编码器和完整特征序列,没有在本文证实严格因果流式约束;低延迟测量不能自动证明不会读取未来帧。单摄像头长期误报、用户定义之间的冲突、门控漏检导致所有定义一起受压制,也都需要另行测试。作者明确列出的主要限制是候选定义依赖和拼接评测的合成性;这些部署问题则是本文分析提出的进一步边界。
DeCoS 的价值可以概括为一句话:让用户换一个定义,再观察系统到底改变了什么。它提供了一套比“接入文本输入就叫开放世界”更严格的检查方法,也给出了轻量修正的证据。但可靠系统仍应同时证明一般异常定位、条件选择、成本和真实场景稳定性,而不是只优化一组新榜单。
来源与核验范围
主来源为 Song 与 Lee 的 arXiv:2607.20780v1,完整 26 页及附录 A—E,图 2—3,表 1—17,许可 CC BY 4.0。必要背景参照 LaGoVAD(arXiv:2503.13160)与 CLIP(arXiv:2103.00020)。本文未运行训练或独立复现结果;基线接口依据该论文附录 C,不能当作所有可能实现的结论。