阅读判断:不需要真实异常,不等于不需要监督
LAVIDA最值得研究的不是把大模型接到异常检测器上,而是把训练问题改写为:**给定一组可能异常的文字定义,模型能否找出视频中真正出现的目标,并输出其时空位置?**它借用外部分割数据构造“伪异常”,训练能够接受新类别提示的检测器。因此,这是相对于目标VAD数据集的零样本迁移,而不是LAVAD那种完全不做任务适配的训练免除路线。二者不能因为主表都写Zero-Shot就视为相同成本。
本文精读arXiv:2602.19248v1,首次提交于2026年2月22日;该版HTML明确标注CC BY 4.0。后续版本存在,本文图、公式与结果均锁定v1,不混用最新版内容。v1最强的证据是跨基准的帧级结果与Ped2像素定位;主要保留意见是,开放类别能力依赖输入异常定义,外部监督与预训练不可忽略,部分消融数值和公式还有需要复现者核对的内部差异。
从语言判断到分割:哪些是继承,哪些是新设计
LAVAD把图像转成描述,再让语言模型评分;它的瓶颈是文字描述漏掉的小动作很难在后续推理中补回来。LAVIDA不把自由生成的异常解释当最终检测结果,而读取多模态大模型中特殊标记的隐表示,再交给分割解码器。这使它能够输出像素位置,但也改变了训练需求。
特殊<SEG>标记的路线来自LISA:用语言模型隐状态连接掩码预测。掩码解码器则继承SAM2的提示式分割结构。它们本身不是LAVIDA原创的机制。本文新增重点是三处连接:如何从普通分割样本制造异常条件,如何压缩多模态模型的视觉输入,以及如何让全片段语义落到逐帧定位。把这三件事分开,才能判断性能究竟来自大模型、分割先验还是新的适配设计。
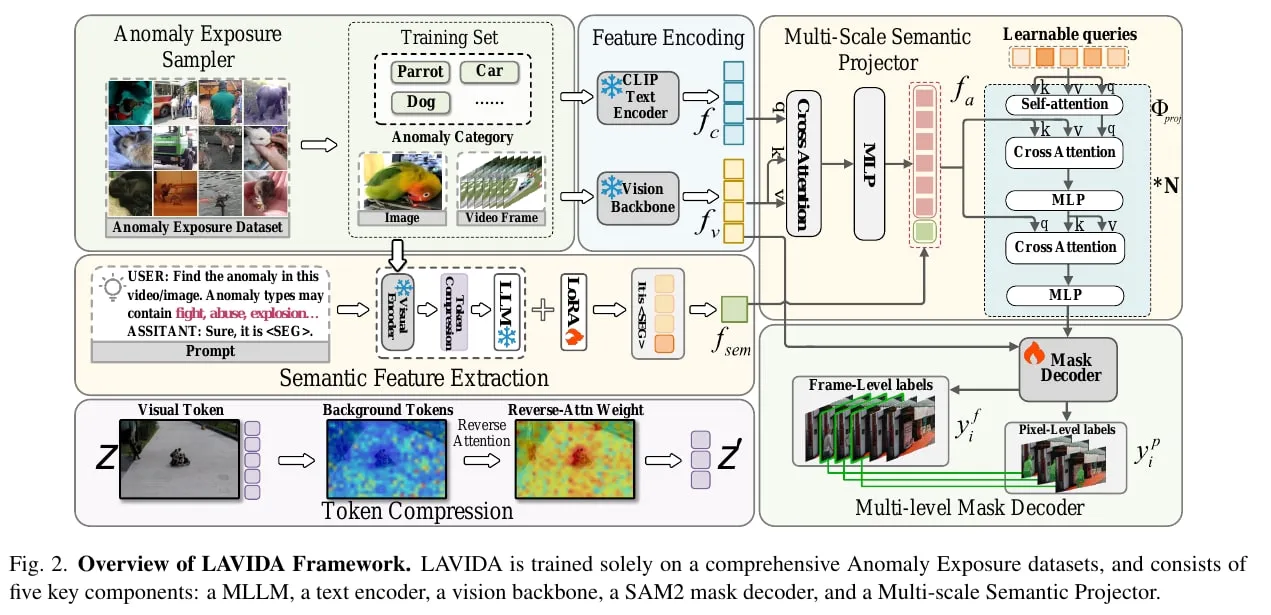
图注:Dai等,LAVIDA v1,图2,物理第3页;CC BY4.0,区域裁剪。两条支路分别保留全局语义与局部定位证据。(LAVIDA v1 图2,CC BY4.0,来源:论文)
读图2时,应沿两条视觉支路看,而不是只盯着LLM。一路经过视觉编码与token压缩,把视频和异常类别提示送入多模态模型;另一路保留视觉特征,并与CLIP文本类别特征交互。全局语义和逐帧语义经过投影器融合,成为SAM2的稀疏提示,最后同时得到像素分数和帧分数。结构上保留第二路非常重要:压缩有助于减少语言模型开销,却不应该把需要精确定位的细节全部丢掉。
按第3节符号,视觉特征为T×Np×Dv,类别文本为K×Dt;类别到视觉的交叉注意力产生T×K×Da,融合后投影到T×Dm的解码空间。这些是符号维度,不是论文已经交代了全部实际隐藏层宽度。图中区分冻结与训练模块,并在语言模型旁标出LoRA;正文损失也包含文本生成项和分割项。因此不能把整个系统描述成“冻结大模型直接推理”,更不能把局部无训练的压缩算法等同整个方法无需训练。
设计一:伪异常是类别条件重标注,不是合成犯罪视频
Anomaly Exposure Sampler首先利用已有分割目标及其描述。从其他样本抽取无关类别,与本样本相关类别组合,构造待检索的异常类别集合;然后以概率p决定该样本被作为异常还是正常条件训练。异常情形把真实存在的目标加入候选集合,正常情形则应只给无关目标,帧标签相应为正或负。监督中的像素掩码来自外部分割数据,而不是目标VAD视频的人工异常标注。
这套设计解决的核心问题是“看到某个物体就永远报异常”:同样的视觉内容,在不同类别条件下应该产生不同答案。它更接近条件目标定位能力的学习,而不是凭空发现一切违反社会常识的行为。训练数据的语义范围扩大,确实可能改善跨场景迁移;但“将分割物体指定为异常”与“理解抢劫为什么异常”之间仍有距离。后一种能力有多少来自大模型预训练,需要额外对照,而不能由伪标签流程本身推导出来。
这里有一个具体复现风险:第3.3节文字说正常样本只含无关类别,但式(2)正常分支排成{s_i},而s_i前文又定义为本样本描述。这两者存在表述冲突。合理意图似乎是排除真实类别,但不能替作者把公式改对后当成已证实实现。复现应检查采样代码和实际batch,而不是机械照抄任一处。
表3也显示类别越多并非越好。候选类别上限从10提高到30时,ShanghaiTech AUC由73.34变为85.02,UCF-Crime由67.11变为82.06;提高到40反而回落到76.41和77.93。作者解释为提示过长分散注意力。但XD-Violence在20时AP为91.20,高于30时90.30,所以“30最优”不是每个数据集都成立。该表支持适中的负类别难度,不支持一个无需验证的通用上限。
设计二:反向注意力保留的究竟是什么
第3.4节不直接预测哪个token异常,而先找“看起来像背景”的密集特征。式(3)用近邻距离平方和的倒数衡量密度,挑选高密度token作为背景参考;其余token按最近参考分组。式(4)在组内使用带负号的点积注意力,使与背景参考不相似的成分得到更高权重,再聚合为少量token。
这不同于简单保留显著目标或全局平均池化:平均池化容易让大面积背景淹没小异常,反向加权则试图保存偏离背景的细节。但“低相似”不等于异常。正常行人、反光和镜头运动也可能与背景不同;大面积烟雾又可能成为高密度内容。图6的热图展示若干目标附近被加强,是工作机制的可视化,不是对所有场景的因果证明。
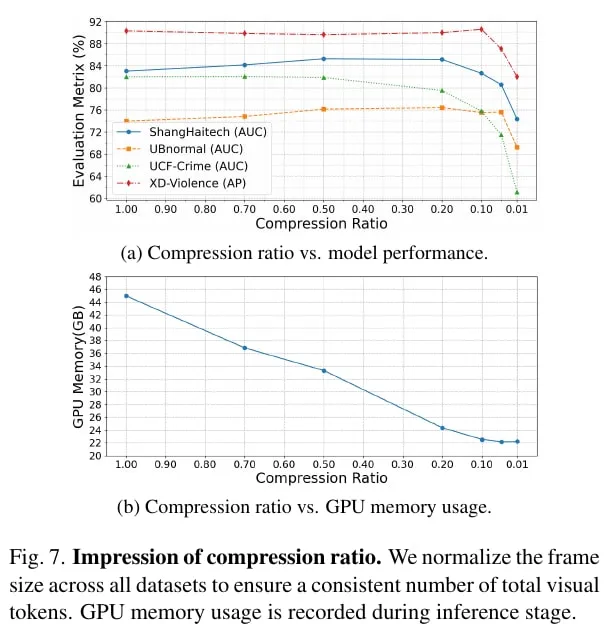
图注:Dai等,LAVIDA v1,图7,物理第8页;CC BY4.0,区域裁剪。须同时看不同数据集的性能下降和显存降低,不能把显存解释为吞吐。(LAVIDA v1 图7,CC BY4.0,来源:论文)
图7需要同时读性能与显存。作者报告保留比例0.2时,显存为不压缩基线的54.1%;这是剩余占用,不是减少54.1%。相应四个帧级基准变化为UBnormal +2.44、ShanghaiTech +2.24、XD-Violence −0.32、UCF-Crime −2.49个百分点,均值+0.47。平均值掩盖了低分辨率UCF-Crime的损失,也不能把AUC与AP的平均提升解释为统一业务收益。低于0.1时明显退化,说明信息压缩并非免费。
该图测的是推理显存,而不是端到端每秒帧数。密度近邻搜索、视觉编码、语言模型、投影器和掩码解码仍需要计算;没有统一硬件与输入长度的完整时延核对,就不能宣称54.1%的显存占用等价于近两倍推理速度。
设计三:全局语义为什么不能直接复制到每一帧
一个片段的<SEG>表示描述整体异常语义,但异常只可能发生在少数帧。把同一个向量复制到所有时刻,容易得到语义正确、时间位置模糊的预测。因此投影器先让类别文本查询逐帧视觉特征,得到局部语义,再拼接广播后的片段语义,通过双向Transformer式的可学习查询完成融合。
这个选择的合理性在于:全局分支告诉模型“应该找什么”,逐帧分支提供“现在是否出现”的证据。解码器把融合表示当成SAM2稀疏提示,掩码提供空间位置,object score logits被用作帧级异常分数。后者本来表征目标存在置信度,并不天然等同异常严重性;只有类别条件和训练监督共同成立时,二者才被连接起来。
表4给出的替换实验比单看架构图更有说服力:相对MLP投影,本文方案ShanghaiTech AUC从81.99到85.28,XD-Violence AP从86.09到90.62,Ped2像素AUC从77.09到87.68。Q-Former对照并未稳定超过MLP,说明“加入查询”本身不是充分条件。不过这仍是当前配置下的组件比较,不是跨多随机种子的稳定性证明;v1没有在这些表格报告误差条。
主结果:哪些提升可以比较,哪些不该混成排行榜
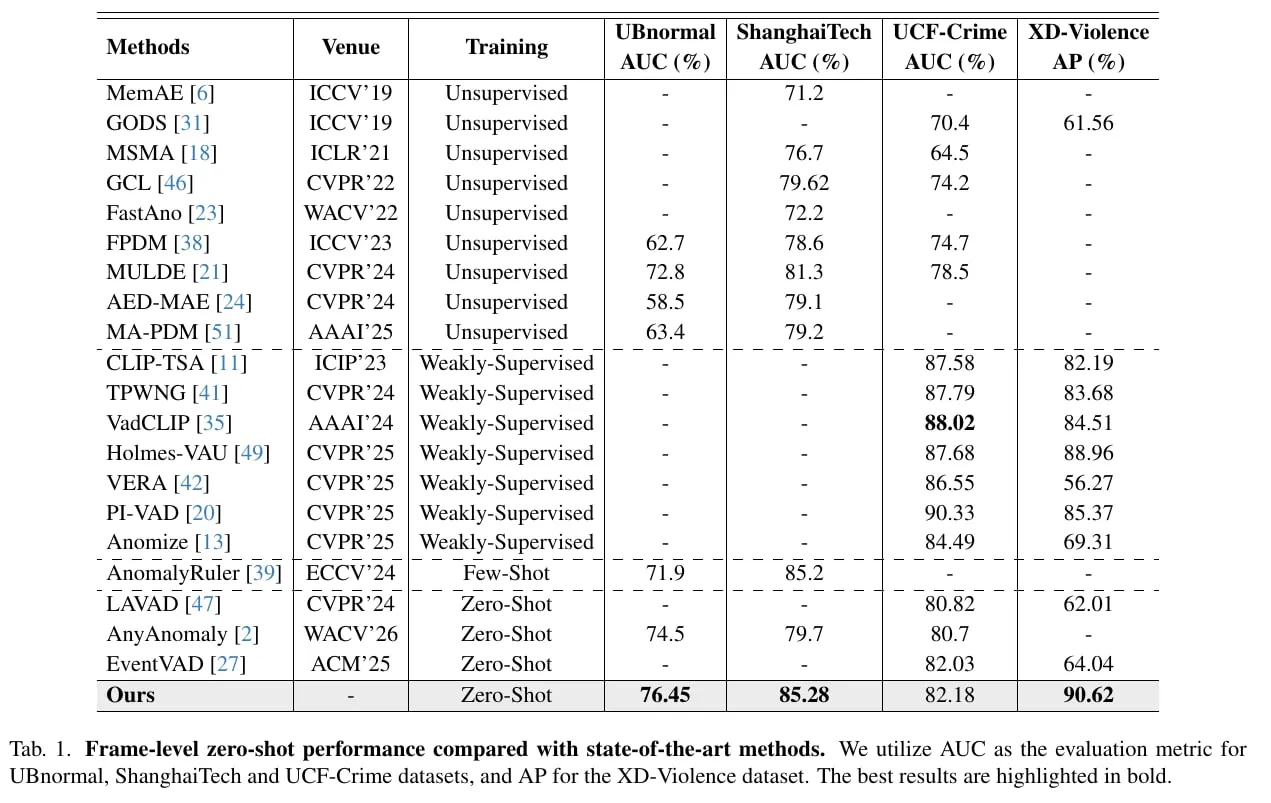
图注:Dai等,LAVIDA v1,表1,物理第6页;CC BY4.0,区域裁剪。保留训练范式和指标表头;跨范式结果并非同成本比较。(LAVIDA v1 表1,CC BY4.0,来源:论文)
表1中LAVIDA的UBnormal、ShanghaiTech、UCF-Crime帧级AUC分别为76.45、85.28、82.18,XD-Violence使用AP,结果90.62。相对表内LAVAD,UCF-Crime高1.36个百分点,XD-Violence高28.61个百分点;但一个经过外部分割监督训练,另一个直接使用预训练模型,不能把差值全部归因于新的推理结构。相对表内EventVAD,UCF-Crime差值只有0.15个百分点,也不宜包装成普遍的大幅领先。
弱监督对照同样要分开看:LAVIDA在XD-Violence超过表内VadCLIP,但在UCF-Crime的82.18低于VadCLIP的88.02。作者将后者不足归因于低分辨率内容难以辨认;这是作者的解释,不是已经通过控制分辨率实验单独识别出的原因。表中监督、特征预训练、训练数据和任务条件不同,它展示迁移竞争力,不是严格同成本实验。
Ped2像素级AUC为87.68,相对表2中的TAO 75.11差12.57个百分点。这是空间定位指标,不是帧级AUC,更不是事件召回率。正常背景像素数量、逐视频还是全局聚合、掩码阈值和评分实现都会影响解读;本文不把像素AUC换写成“87.68%的异常都被找到了”。
还有一处需要保留的数值差异:主表UCF-Crime为82.18,表4本文方案却为82.06;表5查询数48对应ShanghaiTech 80.64,也不是主表85.28。可能是消融设置不同,但v1没有在这些表旁充分说明统一控制条件。稳妥做法是按各表原值引用,而不是替换成同一个最漂亮的数字。
边界与值得做的复现
v1主文及图表已读;其中指向的补充材料未能在本轮可靠获取,训练外部数据完整清单、全部超参数与模型规模仍需补充核验。公开仓库可见训练代码,但README的数据准备与运行说明仍标待更新,不能据此声称“一键复现已验证”。本文也未运行模型。由于这个缺口,不能确认外部数据与测试语义的排除粒度,更不能断言所有预训练内容均不存在重叠。
输入中包含片段及异常类别提示;这不是无条件、无需任务定义的开放世界发现。整个片段的语义用于逐帧解码,也不能直接叫零延迟在线检测:是否使用未来帧、片段缓存多长以及时间后处理,必须在实际推理配置中确认。v1提供了跨数据集评价和典型定位例子,但没有给出足以推出真实部署误报率的事件级统计。
我更希望复现三个小实验。第一,同一段正常视频只改变异常定义,检查分数与掩码是否按语义改变,排除物体类别捷径。第二,控制外部训练数据和视觉骨干,分别移除片段语义、局部语义与反向压缩,明确收益来源。第三,按小目标、低分辨率和背景运动分组,画压缩率—漏报—显存曲线,而不是只报均值。LAVIDA真正有价值的启发,是把异常定位转为可迁移的条件分割;它尚未证明的是,这个条件接口已经足以处理所有未知异常。