XAVAD:先看清解释了什么,再讨论匿名化是否值得
本期论文:Guided Zero-Shot Anomaly Explanation for Anonymized Crowd Video Monitoring,Asres、Jiao、Omlin,2026年10月23日首次提交,v1。受本次资料摘述限额约束,以下采用聚焦短评,不冒充完整长篇精读或复现。
问题与设计:不是另一条异常分数曲线
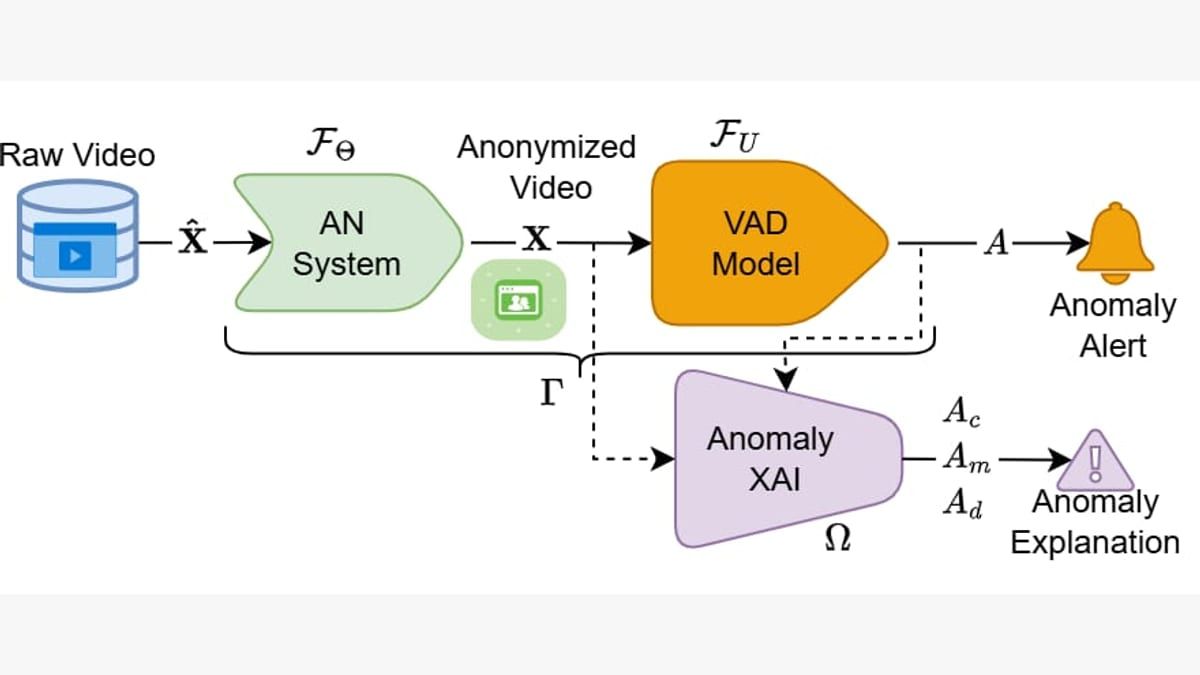
XAVAD接收上游检测器告警,再输出类别、热图和文字解释;它不是新的端到端VAD检测器。PPA沿用CLIP与Grad-ECLIP,新增“先按文本匹配选择图块,再在选中区域计算热图”的流程,以避免小目标在整帧缩放后消失。(原文图2、第三节E)
图注:原文图2,Asres、Jiao、Omlin,arXiv:2610.32073v1,CC BY 4.0。原图未裁剪;箭头区分检测告警与解释输出。(来源:论文)
读图应追踪告警进入解释器的位置。我的判断是:“哪里像这个类别”不自动证明上游报警依据正确。
证据:增益来自聚焦,不只是热图清理
枪械定位实验中,原始Grad-ECLIP的AP为0.307,仅加归一化为0.311,再加PPA为0.569。(表IV)这组逐步比较支持聚焦模块有效;不能据此宣称任何异常都得到更可靠解释。
指标定义不可忽略:这里使用合成Simuletic图像,AP覆盖IoU 0.10—0.50,并非标准COCO AP。(第四节C)因此,“找到附近区域”与“精确圈出目标”不能混为一谈。
边界与下一步
我的研究提问是:主动输入错误类别,解释器是否仍会画出可信的热图?应分别统计正确告警与误报告警,验证解释能否帮助人工拒绝误报。这是待验证建议,并非原文结果。
匿名化也不应仅以画面遮住人体来宣布完成。是否保留任务证据、是否仍泄漏身份,是两个需要分别测量的问题。
原文与图表来源
论文全文及补充材料。配图取自原文图2,归原作者所有,依据CC BY 4.0引用;配图仅用于本文讨论,不代表作者认可本文判断。