两阶段伪标签精读:定位收益从哪里来,证据又到哪里为止?
今天阅读 Wu 与 Lin 的《Two-Stage Pseudo-Label Refinement for Localization-Aware Weakly Supervised Video Anomaly Detection》。论文发表于 Computer Systems Science and Engineering,官网标注刊期发布日为2026年10月27日;这里按期刊刊发日期选入近期阅读,不把它说成已核实的首次预印本上线日。论文与全文
一、先看结论:值得研究的是定位,而不是榜单冠军
这篇工作的观察很具体:先用时序模型产生片段软分数,再让CLIP语义分支学习,可能改善异常区间的识别,但不一定提升全局帧排序。UCF-Crime上,本文AUC为87.41%,低于表中VadCLIP的88.02%;另一方面,五个IoU阈值下的平均定位mAP由6.68提升至7.62。两类指标并不矛盾:高分帧排在前面,与预测区间完整覆盖事件,是不同能力。
阅读时应把“作者提出的机制”“实验观察到的现象”“尚未验证的解释”分开。本文只有一个数据集、单次运行,没有同组件端到端训练对照,因此适合当作两阶段伪标签设计的实证样本,不能据此认定分阶段训练普遍优于联合训练。以下数字、公式与图表均依据原文第3、4节;涉及进一步实验的建议均明确属于本文评论。
二、它接在什么问题后面?
弱监督视频异常检测的输入是长视频与视频级标签,训练时不知道异常片段的准确边界。MIL只需少数高分片段就能把异常视频判对,这使“识别一个最显眼瞬间”与“找全异常过程”出现落差。本文关注的不是额外补充人工片段标签,而是让模型自己生成的片段分数成为下一阶段的监督线索。
按作者相关工作定位,时序建模负责产生线索,视觉语言匹配负责语义调整。这个分工比单纯增加模块更值得检查:如果第一阶段漏掉微小异常,第二阶段究竟能重新发现,还是只会复述第一阶段?如果图传播把异常高分扩散到附近正常片段,语义分支能否把边界收回来?这些问题决定“refinement”是否真的发生。
三、第一阶段:从CLIP特征到软伪标签
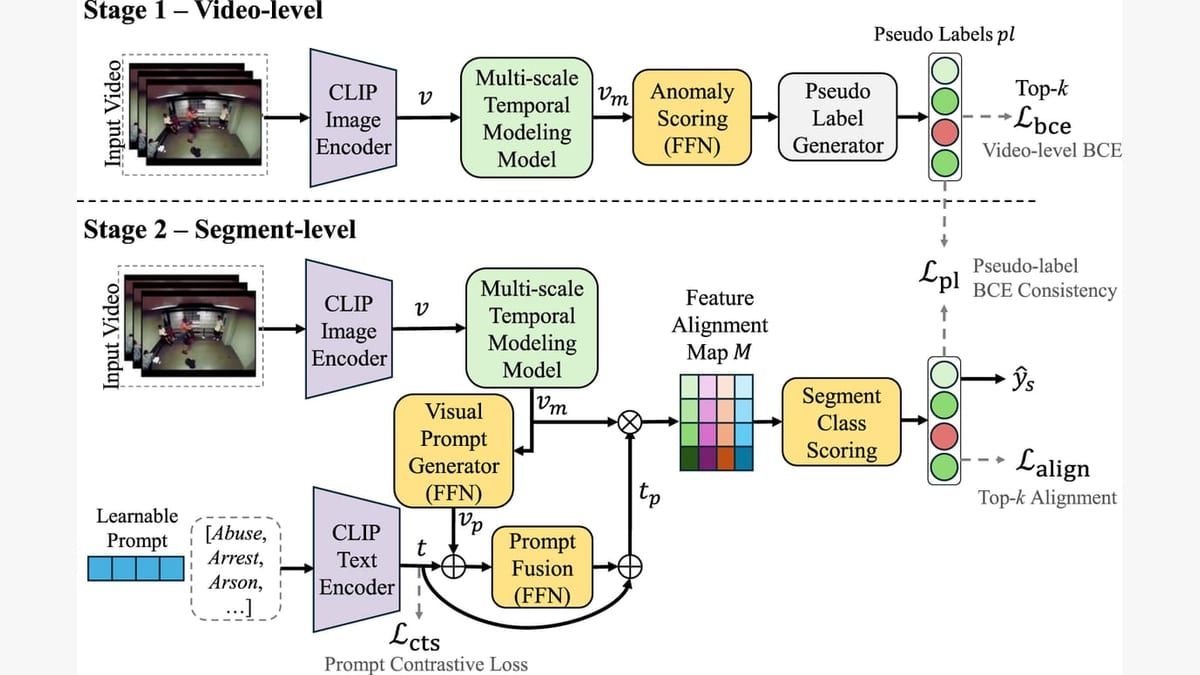
视频被切成不重叠的16帧片段,最多保留256个片段;CLIP ViT-B/16提供512维特征,预训练特征提取器冻结。时间维度上的三个Transformer注意力窗口为2、4、8,因此它们面对的是不同长度的局部片段上下文,而不是三个不同分辨率的图像。窗口变化意在兼顾短促异常和持续事件。
局部特征随后进入双分支GCN。第一张邻接图由片段特征的余弦相似度经softmax得到;第二张图由时间距离构造,权重依据 exp(-|i-j|/σ) 归一化,实验固定σ=1。两个图卷积输出拼接为全局表示 v_m。相似图允许相隔较远但外观接近的片段交换信息,距离图则偏向邻近时刻。
这种设计具有明确风险,而非只增加有效上下文。相似外观未必属于相同事件,时间相邻也不保证标签相同;事件边界附近的图传播可能同时提高事件内部的完整性和事件外部的误报。作者也明确讨论了有害边与图稀疏性尚未分析,因此不能把“双图”直接等同于更可靠的伪标签。
分类头输出T个片段分数,选最高k个取均值,以视频级BCE训练,文中给出 k=T/16。训练完成后保留连续的[0,1]分数作为伪标签,不先阈值化成0/1。这里保留的是模型不确定程度的表达空间,并不代表分数已经校准成准确概率。另一个复现细节是,k遇到非整数或极短视频如何取整,正文并未交代清楚,实施时需要核对代码,不能自行补成作者设定。
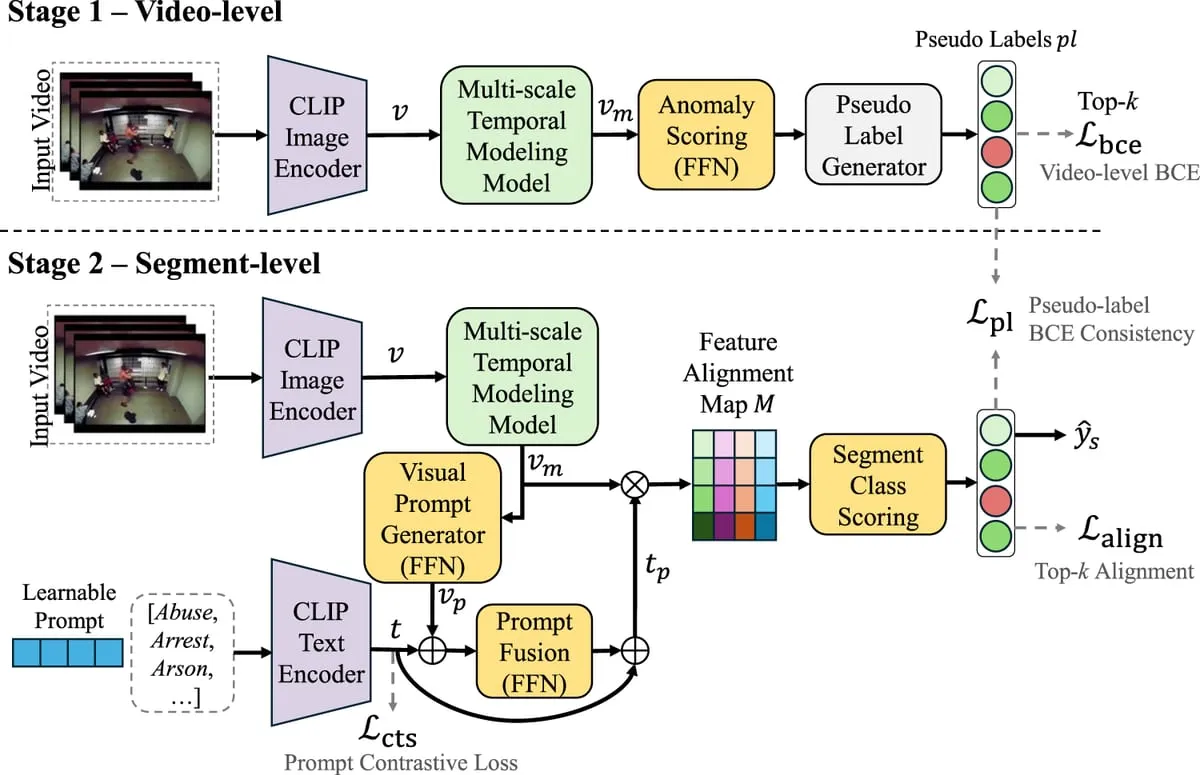
图注:原文 Figure 1,Wu & Lin(2026),CC BY 4.0。未经内容修改;显示两阶段软标签与视觉语言匹配的数据流。(来源:论文)
读这张图应沿“片段特征→时序模型→片段分数→视频级聚合”看第一阶段,再注意软标签与v_m是两条不同的传递路径。它支持理解数据流,不证明输出伪标签已无噪声。
四、第二阶段:语义约束如何与伪标签相互制约?
第二阶段仍利用时序表示v_m,同时为14类构造可学习文本提示,每类20个提示向量,与类别名一起送入CLIP文本编码器。视觉提示v_p由视频表示得到,文本特征按 t_p=FFN(v_p+t)+t 做残差增强,然后与各片段的v_m计算余弦相似度,形成T×14的匹配矩阵。算法2进一步规定,对每个片段沿类别维做softmax,再以1减去正常类概率得到二元异常分数,用它与第一阶段软标签计算BCE;视觉提示由片段表示经FFN生成。因而语义分支并非完全独立的第二位专家,它也使用了第一阶段的表示。
训练包含三项约束。第一项是片段软目标BCE:用第一阶段p指导第二阶段预测q,其形式为 -p log q-(1-p)log(1-q)。这项损失单独优化时,方向是让q靠近p,并没有自动识别错误伪标签的能力。对“纠错”的期待主要来自另外两项约束,而不是软标签三个字本身。
第二项把各类别的片段相似度沿时间聚合,再以温度0.07做softmax,与视频类别计算交叉熵。第三项惩罚正常提示与异常提示之间正的余弦相似度,促使两者分离。总损失为 L_pl+L_align+0.1L_cts。这个所谓对比项是正常—异常文本嵌入的分离正则,不应误写成带实例正负样本挖掘的完整InfoNCE框架。
软目标一致性保留时间线索,类别监督约束视频语义,提示正则抑制正常与异常文本混淆。从优化角度看,它们可能相互纠偏,也可能发生冲突。正文没有分别消融三个损失,也没有直接报告第一阶段与第二阶段伪标签的准确率、召回率及边界偏差。因此,“语义纠正了哪些片段”目前主要是设计解释,尚非由逐片段纠错统计直接建立的事实。
这里还有一个必须先澄清的监督口径问题。第3.1节写视频标签为二值,且异常类别只用于评估;但式11又明确使用ground-truth class label做14类交叉熵,算法2也写出视频类别one-hot目标。如果确实使用视频级异常类别,就需要说明类别标签属于训练监督;如果只有正常/异常二值标签,则需要解释14类目标怎样生成。两处表述不能直接同时作为已确定的实现依据。这是文本中的复现疑点,不据此推断作者造假,也不擅自替作者补一个训练方案。
五、实验:把AUC、定位与消融放在一起读
原文比较首先给出AUC:本文87.41%,VadCLIP88.02%,差距为-0.61个百分点。因此标题中的“定位感知”应落实到定位表,而不是用总体检测更好来概括。下面重排原文表3,保留其类别感知、时间区间IoU的评估含义;它不是普通二分类AP,也不能与XD-Violence常用的帧级AP直接横比。
| 方法 / mAP(%) | IoU 0.1 | 0.2 | 0.3 | 0.4 | 0.5 | 平均 |
|---|---|---|---|---|---|---|
| VadCLIP(原文表中值) | 11.72 | 7.83 | 6.40 | 4.53 | 2.93 | 6.68 |
| 两阶段方法 | 13.60 | 9.82 | 6.42 | 4.86 | 3.40 | 7.62 |
| 差值,百分点 | +1.88 | +1.99 | +0.02 | +0.33 | +0.47 | +0.94 |
低IoU阈值的增益较大,0.3处仅差0.02个百分点,不能将所有阈值上的正差都描述成显著改善。它更支持“部分定位指标变好”的有限结论,而不是已经解决精确边界定位。严格阈值下的绝对mAP仍低,也提醒我们不要只报告相对提升比例。作者没有给多随机种子均值或标准差,无法从这张表判断小幅差异能否稳定复现。
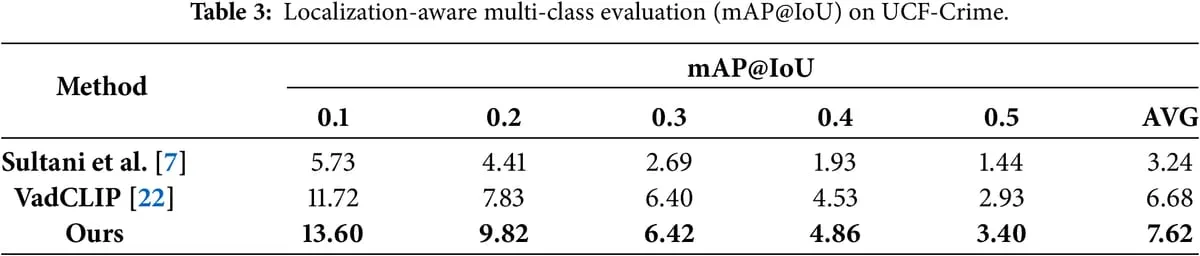
图注:原文 Table 3,Wu & Lin(2026),CC BY 4.0。未经内容修改,保留方法名、指标、IoU阈值与平均列。(来源:论文)
截图应与重排表交叉阅读:看指标名与IoU列,再看两行方法,不把平均列当成AUC。表格建立了结果差异,但没有隔离增益来自伪标签、提示学习还是训练流程变化。
原文表4的四组AUC依次为:基线84.59;加入伪标签85.28;加入多尺度时序建模86.24;两者同时加入87.41。伪标签单独增加0.69个百分点,时序模块单独增加1.65,而在已有时序模块上加入伪标签再增加1.17。这提示伪标签的用途依赖生成它的表示质量。但不能简单把1.17与0.69的差称作已证实的因果协同:缺少重复运行,也未控制每个模块和训练步骤的贡献。
尤其需要注意,消融报告的是AUC,而文章主要优势叙事是定位mAP。若要证明“伪标签主要改善定位”,更直接的证据应当是同样四组配置的mAP及边界误差,而不是将一张AUC消融与另一张完整模型定位表拼成因果链。这是后续复现最有价值的补充之一。
六、成功与失败:时序连续性也会制造拖尾
原文图4展示正常、抢劫、爆炸、破坏事件。正常例子保持低分,抢劫例子覆盖持续区间;但爆炸结束后仍有高分,作者推测持续烟雾会保留异常视觉线索。破坏例子几乎整段都被打高分,而标注仅覆盖其中一部分。可见更连续的响应既可能补齐异常,也可能使边界后的正常片段继续报警。
图5的Robbery050则相反:车内发生的微妙抢劫事件被漏检,整段分数偏低。作者讨论了明显对抗不足、车窗内局部细节难以辨认等可能原因。这与前述拖尾一起构成更真实的能力边界:加强时间上下文不能代替细粒度对象和交互语义,也不能保证边界收缩。
这些均是作者选择的定性样例,不是大规模错误类型占比。合理的下一步是统计高分拖尾长度、事件召回、每小时误报,以及微小物体/遮挡事件的分组表现;不应将个别成功曲线写成系统已具备部署鲁棒性。
七、复现与借鉴:先厘清监督,再验证真正的纠错
实验配置并不隐藏:16帧片段、最多256段、冻结CLIP、两阶段各10轮、AdamW学习率2×10^-5、batch size 32。但复现应先确认类别监督口径、阶段二哪些参数继续更新、伪标签是否固定,以及视频分数到事件区间的生成规则。论文声称验证集调参,却没有完整给出划分与事件后处理的可复现细节;这些都可能影响定位mAP,不能用习惯实现替代论文证据。
借鉴这项工作时,最值得检验的假设是:语义分支能否纠正时序模型的系统性错标。可以固定相同特征、标签和预算,比较单阶段、冻结伪标签两阶段、同组件联合训练;再分别记录伪标签在事件内部、边界和背景上的变化。同时拆开相似图、距离图与三个损失,观察提升究竟发生在完整性、边界精度还是全局排序上。这些是本文提出的验证方案,不是论文已经完成的实验。
总体而言,这篇论文的价值在于提供一个可分析的“时序线索生成→语义精炼”结构,并用定位指标提醒我们AUC不是全部。现有结果支持在UCF-Crime上继续研究这种分工,但尚不足以证明干净伪标签、广泛泛化或两阶段训练的普适优势。对伪标签方法而言,最关键的证据仍是:它纠正了什么,是否稳定,以及是否只把错误变得更连续。
来源与图表许可
原文:Meng-Luen Wu、Yan-Hsin Lin,Computer Systems Science and Engineering 50(1):21–45,DOI 10.32604/csse.2026.082744。官方全文。原文采用CC BY 4.0;本文为中文原创分析,数据表为依据原文表3重新排版,差值为本文计算。图表归原作者所有,配图保留原编号并在图注说明未经内容修改。本文未运行作者代码,未将所提复现实验描述为已完成结果。