先说判断:最值得留下的不是 PAVA,而是“别丢掉模型的犹豫”
Probe-VAD 研究的是无需目标任务训练的视频异常检测:给未裁剪视频逐帧排序,而不是生成一段异常解释。它真正有价值的改变,是把冻结视觉语言模型(VLM)的输出接口,从“请直接报一个分数”改成“对一组严重程度问题,分别读取 YES/NO 的相对似然”。最强证据不是排行榜,而是固定视觉输入、提示与候选数字后的对照:保留似然比直接生成数字高出 5.59—14.23 个 AUC 百分点。主要保留意见也很明确:额外的序数收益与二元问法共同变化;PAVA 在默认等权设置下根本不改变最终分数,不能被包装成精度提升来源。
本文是旧稿精读,不是今日新论文。官方论文首次提交于 2026 年 9 月 15 日,当前仅 v1,标记 Under Review。完整标题为 Probe-VAD: Ordinal Likelihood Probing for Training-Free Video Anomaly Detection;作者为 Jiawei Gu、Qilin Zhao、Tengkuo Guo、Zhiming Zhong、Shuangqing Zhang、Fan Lyu、Fang Zhao、Guo-Sen Xie、Caifeng Shan。以下依据全文、图表及作者公开实现;论文为 CC BY 4.0,图表按原编号署名引用。
创新落在哪里:换评分接口,不换视觉骨干
先把三类变化分开。
- 相对 LAVAD:后者先生成描述,再做描述清洗、时序总结、语言模型评分与跨模态精炼;Probe-VAD 不再以文字描述作为评分必经入口,直接保留视频视觉条件。这是移除中间压缩环节,不是发明免训练 VAD。LAVAD §3
- 相对直接数字生成:同样看视频,但不只保留最后选中的 0.1、0.2 等数字,而是利用候选回答的分布。这里改变的是读出方式,不是增加训练数据。
- 相对 LogicQA:用回答似然辅助异常评分已有先例;LogicQA 面向工业图像逻辑约束,从正常示例形成问答清单。Probe-VAD 新增的是视频片段上的统一严重程度阈值链,以及累积证据聚合,不宜把“读取 YES/NO 概率”本身当作全新机制。LogicQA §3、§5.2
因此,这是一种具体的接口组合创新:冻结 VLM、候选似然、序数提问、等权汇总与时序还原。能否成立,要看接口改变后的受控实验,而不是架构框图里模块的数量。
走通一次推理:十个问题共享一次视觉编码
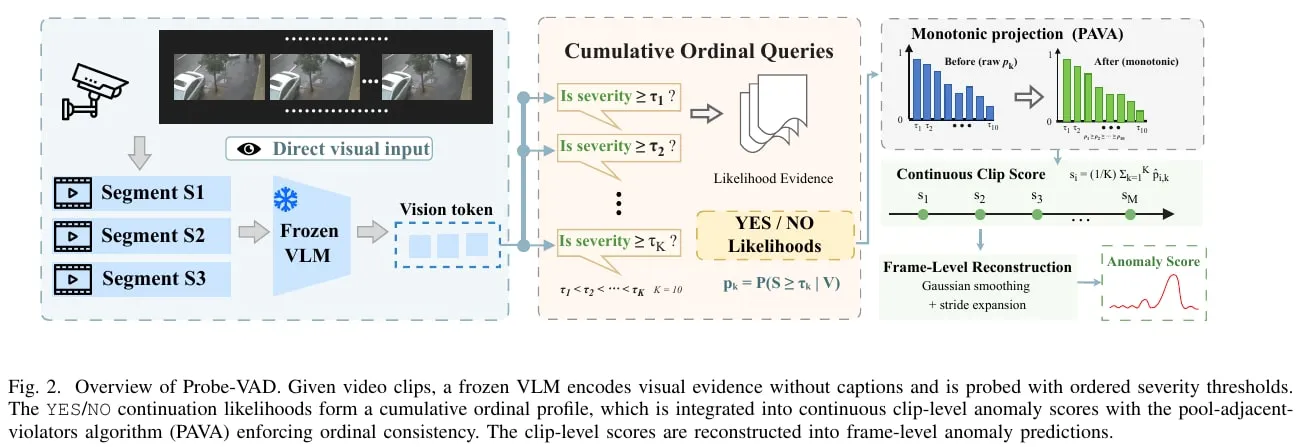
图注:原论文图2,物理第4页。看清一次视觉编码如何复用于十个问题;右侧PAVA修正中间形状,但默认等权均值保持不变。Gu等,Probe-VAD,CC BY 4.0。(Gu et al., Probe-VAD, Fig. 2, PDF p.4, CC BY 4.0,来源:论文)
沿图 2 从左到右看:原始视频先切成重叠片段;冻结的 VideoLLaMA3-7B 编码视频,视觉表示被十个阈值问题复用;每个问题产生两个候选的似然;得到长度为 10 的证据向量,经单调投影和求平均后,输出一个片段分数。最后进行高斯平滑与帧级展开。图中的雪花意味着骨干冻结,没有另行训练的分类头。
默认片段长 10 秒、最多保留 10 帧。作者实现规定中心帧间隔 Δ=16,采样参数为 2 FPS 并受帧数上限约束;不是每个原视频帧都送进大模型。十个问题共用视觉编码及投影,可批处理文本后缀、复用前缀 KV cache。批大小是效率/显存参数,不是新的评分规则。隐藏表示维度未在这里自行补写。论文 §III-B、III-E;实现规范
整个流程没有目标域参数更新、提示学习或标签校准,但“免训练”不等于“没有预训练知识”:视觉感知与语义先验全部来自既有 VLM。本文也不据此推断预训练数据与评测视频绝无重叠。
设计一:用相对似然保住数字解码丢掉的信息
对片段 i、阈值 k,先累加候选回答各 token 的条件对数概率,记作 ℓYES 和 ℓNO;再计算:
pᵢₖ=exp(ℓYES/T)/[exp(ℓYES/T)+exp(ℓNO/T)],默认 T=1。
这是原文式(4)—(6)。通用定义支持多 token 候选;公开优化实现先检查 YES、NO 均为单 token,再读取其 logits。两种写法在对应设置下不是两个模型。
直觉上,两个片段都可能被模型报成“0.5”,但一个只是略倾向 0.5,另一个把大量支持分配给更高程度。只读取生成结果会把它们并列,似然读出则保留这种差别。直接替代方案是对十个互斥数字候选读取完整分布并计算期望;论文正用它作为关键中间基线,而不是只比较一个刻意弱化的生成器。
设计二:问“至少多严重”,但不把回答当真实风险概率
阈值 τₖ=k/10,依次为 0.1 至 1.0。每次问的是片段严重程度是否至少达到该阈值;理论上,支持“至少 0.8”应同时支持“至少 0.3”。因此十个支持度应随阈值增大而不增。这是严重程度上的顺序,不是视频帧的时间顺序。
原文用有界变量的尾积分恒等式启发聚合,默认分数为 sᵢ=Σp̂ᵢₖ/10,即十个阈值证据的平均。这里的潜在严重程度没有人工严重度标签监督;论文明确说 p 和 s 都未经过概率校准。因此 0.8 不能解释为“80% 会发生事故”,平均值也不是经过验证的真实损害期望。其用途是异常帧排序。[§III-C、III-D,式(9)—(11)]
设计三:PAVA 修的是曲线形状,不是最终检测成绩
实际回答可能违背单调性。PAVA 将相邻违序块替换为块内均值,求到距离原向量最近的非增序列。例如本分析的示意向量 [0.8,0.3,0.5] 可修成 [0.8,0.4,0.4]:形状变了,总和没有变。
这正是式(12)—(14)的关键。默认均匀阈值、等权积分下,投影前后片段分数相同,后续平滑输入也相同;它无法提高最终 AUC。作者实测最大标量差仅 4.44×10⁻¹⁶,符合浮点误差。若只需要最终排序,保留原始均值是直接替代;若要展示每个阈值的累积曲线,PAVA 才提供结构一致性。这个判断不能直接外推到非均匀网格的加权聚合。
实验:先看真正受控的比较,再看排行榜
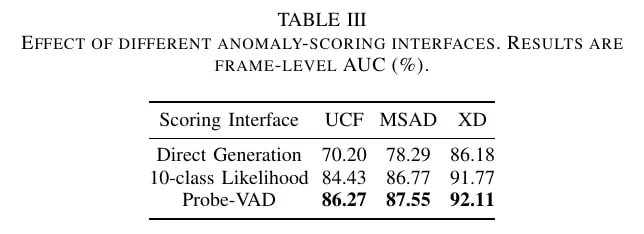
图注:原论文表III,物理第8页。单位为帧级AUC(%),越高越好。第一到第二行隔离似然保留;第二到第三行同时改变候选语义与提问分解。Gu等,CC BY 4.0。(Gu et al., Probe-VAD, Table III, PDF p.8, CC BY 4.0,来源:论文)
表 III 应纵向看两个台阶,而不是只看最后一行。第一步固定视频、数字提示和十个候选,只把“生成一个数字”换成“读取十类似然”:UCF-Crime 从 70.20 到 84.43,MSAD 从 78.29 到 86.77,XD-Violence 从 86.18 到 91.77,分别增加 14.23、8.48、5.59 个百分点。这是支持“解码接口损失排序信息”的最强实验。
第二步换成 Probe-VAD,得到 86.27、87.55、92.11,额外增加 1.84、0.78、0.34 个百分点。但此时数字候选变成 YES/NO,互斥多分类也变成累积二元问题。作者在 §IV-C 已承认两项共同变化。因此这些数字支持“整套累积接口有效”,不能单独证明纯序数结构有效,更不能归功 PAVA。表中没有为这些差值给出重复运行方差,尤其不能把 0.34 点写成稳定显著优势。
视觉信息与时间信息:两个不同问题
表 II 固定序数似然评分,比较文字描述输入与视频输入。三个数据集 AUC 分别是 UCF 80.70→86.27、MSAD 86.79→87.55、XD 91.70→92.11。它支持中间描述可能丢失排序线索,但没有隔离究竟是小物体、交互还是背景细节造成差距,不能替作者指定原因。
表 IV 则显示:UCF 单帧 83.20,多帧乱序 86.14,多帧有序 86.27。多看若干状态的收益明显大于保持精细顺序的 0.13 点差异。这不是“模型已经理解动作因果”的证据;更合理的解释是它主要受益于多帧覆盖。动作顺序决定异常与否的场景仍需专门验证。
主结果有提升,但必须保留协议标签
表 I 中,Probe-VAD 的 UCF AUC 为 86.27;XD AUC/论文所称 AP 为 92.11/75.36;MSAD 为 87.55/78.43。对应表内最强可比免训练基线为:UCF 的 PANDA 84.89;XD 的 URF-HVAA AUC 91.34、PANDA AP 70.16;MSAD 的 URF-HVAA 85.90/76.40。五项差值依次为 1.38、0.77、5.20、1.65、2.03 个百分点。它是跨骨干、时序处理与预处理的系统比较,不是同预算替换模块的试验,也不是截至今天所有新方法的完整排行。
评测使用 UCF 290、MSAD 360、XD 800 个测试视频。MSAD 的 360 视频划分不同于 VADTree 的 240 视频划分,作者没有把后者对应数字硬放进直接排名。当前公开评估代码把所有测试视频帧拼接后计算 ROC-AUC,属于全局帧级统计,而非逐视频宏平均或事件检测指标。
还存在必须披露的指标命名差异:论文写 AP,当前公开代码却用 precision_recall_curve 后的梯形面积 auc(recall, precision),并保存为 PR-AUC。这与 average precision 的常见实现不是同一公式。这里保留论文原标签,不擅自重算或断言全部表格都由当前版本代码产生;复现时应先核清具体代码版本和积分约定,再比较几个百分点的差距。评估器
增加问题、平滑与速度,都有收益边界
表 VIII 中 MSAD 的阈值数 K 从 1 增至 10,AUC 86.97→87.55、论文 AP 76.77→78.43;从 5 到 10 仅再增 0.14/0.31 点。K=1 固定问 τ=1.0,并非“所有单问题方案的最优值”,因此不能推导十问普遍优于一切单问策略。
表 XII 反而给出一个值得保留的负结果:不平滑时 MSAD AUC 88.13,高于默认 σ=10 的 87.55;σ=20 更降至 86.65。它证明默认平滑并非必需增益模块,也提醒短异常的边界可能被抹平。不能事后把最优平滑数字替换进主结果。
表 XIII 在相同 50 个 MSAD 视频、2235 片段上比较完整流水线:Probe 用时 1:58:37,描述流水线 4:49:19;有效吞吐 3.14 对 1.29 FPS。所谓 FPS 分母是实际送入模型的 22350 张采样帧,不是视频原始帧率。端到端比较包含模型处理,论文说明主推理使用 A100;持久中间产物 0.77 对 6.06 MB 不含原视频,也不等于显存用量。59.0% 时间节省是相对此处描述流水线,不能改写成实时监控能力。
看失败图:评分接口救不了没有看见的证据
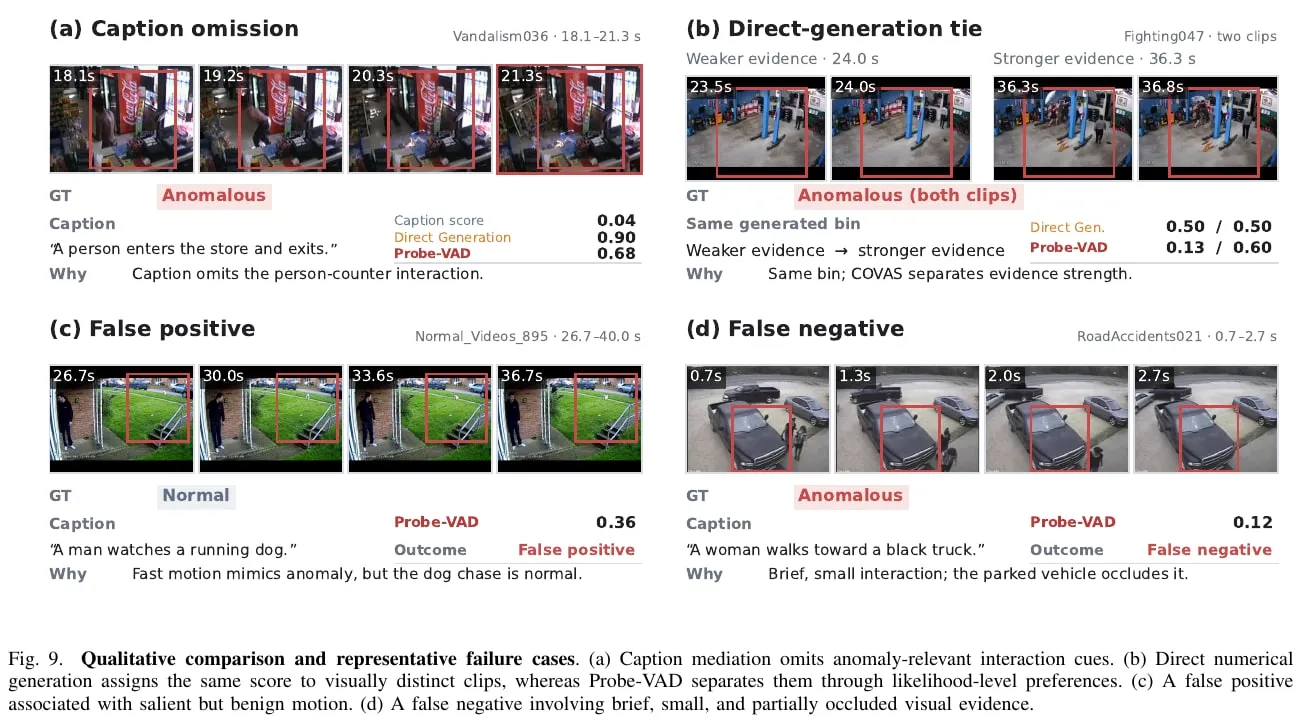
图注:原论文图9,物理第12页。上排展示评分瓶颈,下排展示感知失败;均为定性个案,不能替代误报漏报率统计。Gu等,Probe-VAD,CC BY 4.0。(Gu et al., Probe-VAD, Fig. 9, PDF p.12, CC BY 4.0,来源:论文)
图 9 的上排展示描述遗漏交互、直接生成把不同片段压到同一档;下排才是边界:正常但显眼的运动触发误报,短暂、小而被遮挡的异常被漏掉。应把它们读成作者挑出的机制示例,而非所有场景错误率的统计。论文没有用这些个案证明“接口改进解决了感知问题”。
另一项部署边界来自本分析对公式和实现的核验:10 秒窗口以目标中心为轴,会使用其后最多约 5 秒画面;默认高斯平滑也使用两侧片段。公开评估器未见逐视频 min–max 归一化,但不做整段归一化不代表因果推理。这套结果不能直接当成严格在线报警结果,事件延迟与固定阈值误报率仍需另外评估。
作者承认的核心限制是继承冻结 VLM 的感知错误;作者同样承认序数与二元问法的混杂;本分析另行核验了 AP/PR-AUC 命名与非因果时间窗口。三者影响的是不同结论,不能混成一句笼统的“泛化有待提升”。
值得继续验证什么
最直接的研究启发不是再堆一个模型,而是把感知能力、评分读出与报警协议拆开。可以在同一冻结骨干、同样视觉预算下,比较互斥数字似然、累积二元似然和预算匹配的单阈值问法;这是建议实验,不是论文已经完成的结果。
复现时先保存每个阈值的原始似然,检查等权 PAVA 前后均值不变,再锁定视频名单、Δ、平滑和 PR 积分口径。最后若面向实时系统,应把居中窗口改成只看过去,并重新测定位和告警延迟,而不是沿用离线成绩。Probe-VAD 最扎实的启示是:模型已经看见的信息,也可能在“让它说一个数”的那一步被我们丢掉;把信息读出来,仍不等于把检测系统做完。
主要来源:论文全文与全部图表、PDF、官方代码、补充实验记录。本文图 2、表 III、图 9 均摘自 Gu 等人的同一论文,依据 CC BY 4.0 署名使用;文字为独立分析。核验日期:2026 年 10 月 31 日。