先给判断:部署证据扎实,准确率结论要刹车
YUTELA 研究的不是“再造一个异常分数”,而是怎样让视频异常检测在多地点、多人流、持续更新的真实摄像头网络中运行。它的价值在于把嵌入式推理、共享流水线和按相机场景重训连接成闭环;最强证据是受控负载对照,以及四个站点、31 路摄像头连续 170 小时的运行记录。主要保留意见同样明确:作者没有验证更新后的模型是否比初始模型检测得更准。训练流程跑通,不等于域适应有效;吞吐变高,也不等于告警更快。〔原文 §V、§V-D〕
本文精读 2026 年 10 月 19 日首次提交的 v1,而非今日新稿;选用较早论文,是在近期候选材料不足后按已获授权的日期放宽处理。作者为 Shanle Yao、Babak Rahimi Ardabili、Amir Kimiyaie、Hamed Tabkhi。全文采用 CC0 许可,以下将原文事实、作者解释和本分析判断分别表述。
新在哪里:把已有模块组织成可持续运行的系统
最接近的系统是团队此前的 Ancilia。后者已经有多进程流水线、批处理和异常检测扩展,不能因为 YUTELA 表 I 的某个比较栏写“—”,就说旧系统没有 VAD。YUTELA 的变化是:把现场工作站替换成 Jetson Thor;在地点层共享多摄像头资源;更新感知模块;将相机专属异常模型的训练集中到全局节点。〔Ancilia §IV-C、§V;YUTELA §III〕
第二个直接来源是 SPARTA,负责姿态异常评分。YUTELA 沿用它,而非提出新的骨架建模损失。第三个来源是周期适应前作,提供伪标签过滤、收集、更新和权重返回的思路;YUTELA 强调按相机保存独立模型、按有效数据量触发。前作零售数据上的准确率结果,不能挪作这次四站点部署的效果证明。〔YUTELA §III-D、参考文献 30、51、52〕
因此,本文应按系统设计与评测论文阅读:新意主要在资源组织和更新机制的部署,而不是把 YOLO、跟踪、姿态、Transformer 的组合都算作新算法。
从视频到告警:两条路径,不是一个模型包办
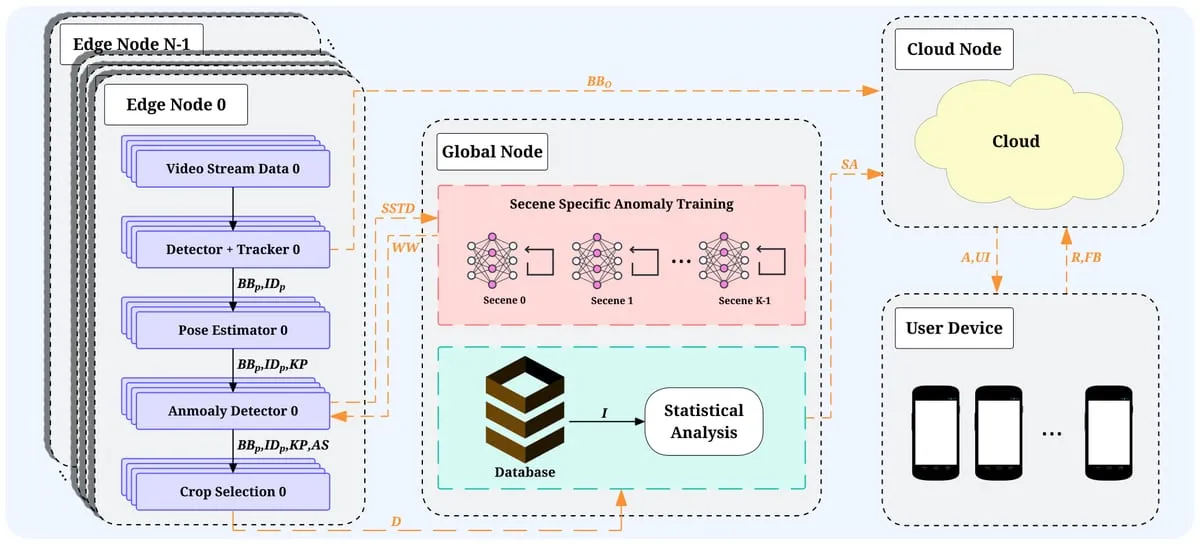
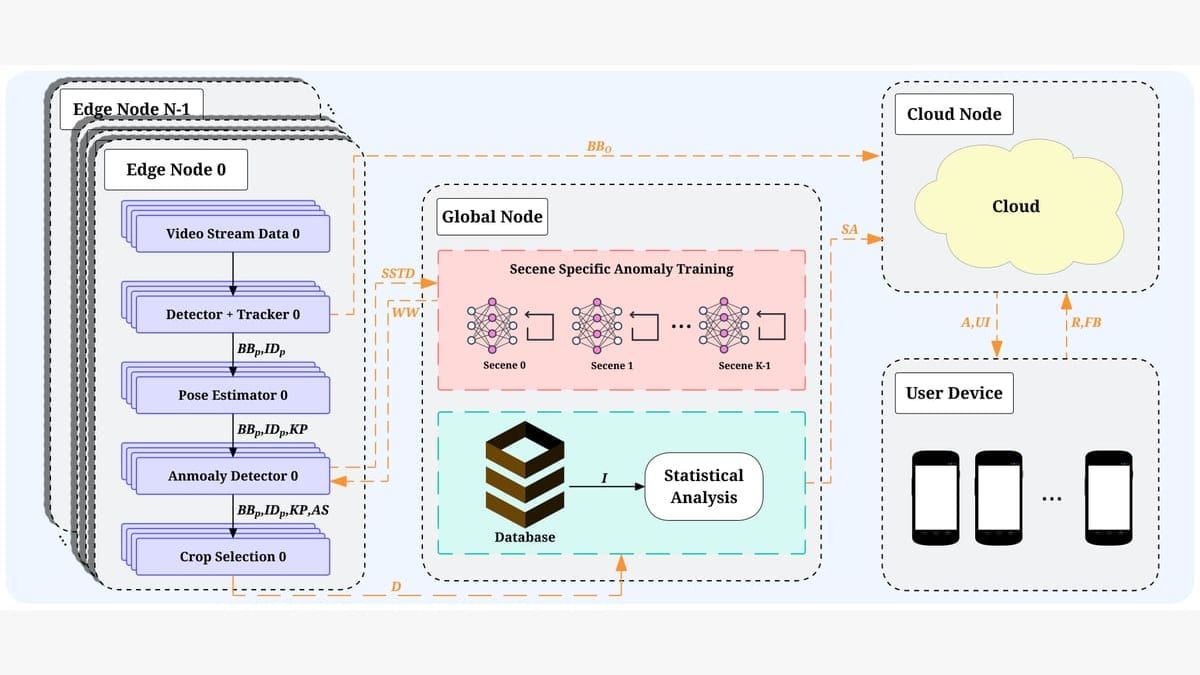
图注:YUTELA 图 1:系统架构与数据流。对象异常走边缘到云端路径,行为异常经过全局统计分析;箭头表示职责而非准确率增益。来源:Yao 等,arXiv:2610.26468v1,CC0。(来源:论文)
图 1 要先看两种异常的去向。对象异常从边缘节点直接发往云端;行为异常连同特征和上下文批量交给全局节点,经统计分析后再进入告警服务。前者优先响应速度,后者为减少场景相关误报保留额外分析。这张图支持“职责拆分”的设计判断,但全局统计分析的完整判定式没有在文中展开,不能把这条箭头当作误报率下降的实验证明。
现场处理链为:摄像头输入→检测→行人跟踪→姿态估计→SPARTA 异常推理→重批处理与特征/元数据传送。表 I 列出 YOLO26、ByteTrack、AlphaPose、SPARTA;全局节点还保存相机、位置、身份编号、框、人数与运动等上下文。云端承担告警和交互,不承担所有原始视频的持续集中推理。〔§III-A–C、§IV-C〕
为理解评分器的职责,可参考 SPARTA:它对关键点序列及相对位移进行时空编码,以重建/预测误差反映异常。但 YUTELA 没有明确部署哪个分支、全部张量维度或归一化范围,因此不能把前作某个默认配置冒充这里的实现。“预测未来”的解码器名称也不等于提前预警:误差仍要与已经观测到的目标序列比较。〔SPARTA §III-A–B〕
推理在边缘持续运行,场景模型更新在全局 GPU 上执行。原文明确重训异常模型,却没有完整列出各感知网络的冻结清单;可确认的是训练职责分离,而不是所有模块都在线学习。
三个值得拆开的设计
1.共享流水线:减少重复工作,不只是换一块 GPU
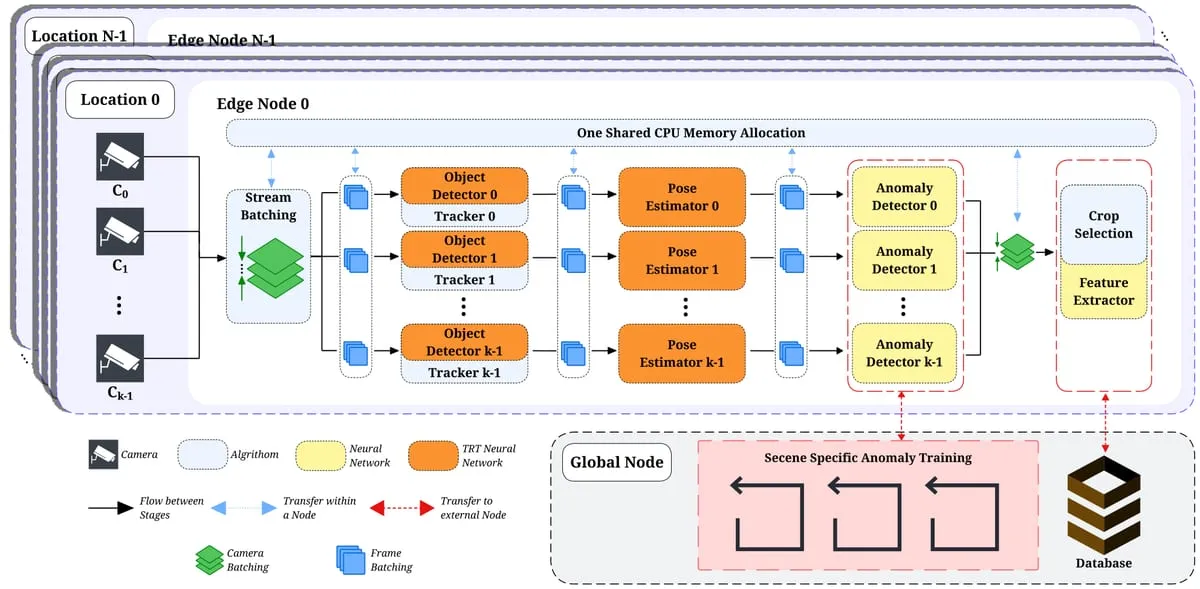
图注:YUTELA 图 2:共享边缘流水线与按相机场景适应。重点比较地点级资源共享和相机级模型独立性。来源:Yao 等,arXiv:2610.26468v1,CC0。(来源:论文)
图 2 应沿上方数据流看“多摄像头共享”,沿下方闭环看“各相机独立适应”。每个相机都拥有独立端到端流水线时,模型实例、内存和中间数据搬运会重复。YUTELA 先对输入批处理、再分配到可用流水线,使流水线数不必等于相机数;CPU 中间结果使用共享内存,检测与跟踪等轻量相邻阶段合并;异常推理后重新成批,供共享下游处理。〔§III-D〕
直觉是把资源分配单位从“相机”变成“地点”,同时保留相机身份。直接替代方案是每相机独占流水线:隔离更清楚,但资源重复更多。共享方案需要处理拥塞、公平性与队列等待;论文给出了整体吞吐/延迟,却没有逐项关闭共享内存、重分配、阶段合并的消融。所以只能评价整套重构,不能给每个模块分配独立贡献。
2.按数据量重训:更新频率由有效观察决定
每台摄像头被视为独立场景。部署样本先被伪标注,仅保留被判为正常的样本;累计约一百万个包含有效人体姿态观察的帧后,在全局节点启动该相机模型的训练,再把权重送回边缘。训练集使用近期部署数据,而不是混合全部相机历史。〔§III-D〕
用记号表达这一工程逻辑:设相机 c 自上次更新后积累的有效样本量为 N_c,达到阈值 T 后触发更新;这里 N_c、T 是本分析的说明记号,不是论文新增损失。与固定每隔一天重训相比,安静场景不会因时钟到点而用少量数据反复更新,繁忙场景则更快达到门槛。
但“有效样本量”不等于“新信息量”,大量相似姿态可能重复贡献计数;伪正常过滤还可能把漏检异常带回训练。作者在 §V-D 承认后一风险。本文未提供适应前后标注测试,故该机制目前证明的是可执行性与负载差异,不是抗漂移准确率。
3.集中训练、分布推理:省边缘算力,也引入同步问题
四个边缘节点共用全局工作站,后者配置 Threadripper PRO 5975WX 与两块 RTX A6000;训练不占用现场 Thor 的推理 GPU。常规通信以选定特征、训练数据和权重为主,不要求持续上传全部原始视频。〔§IV-B–C〕
替代方案是在每个边缘设备训练,能够减少对中心的依赖,却会与推理争抢资源。集中方案则需要应对上传、训练排队和更新突发。本分析认为,这里最值得复现的不是单次训练耗时,而是多相机同时触发时的排队尾延迟:论文后面的容量外推尚未覆盖这一情形。
实验一:TensorRT 的收益清楚,“全面更快”不成立
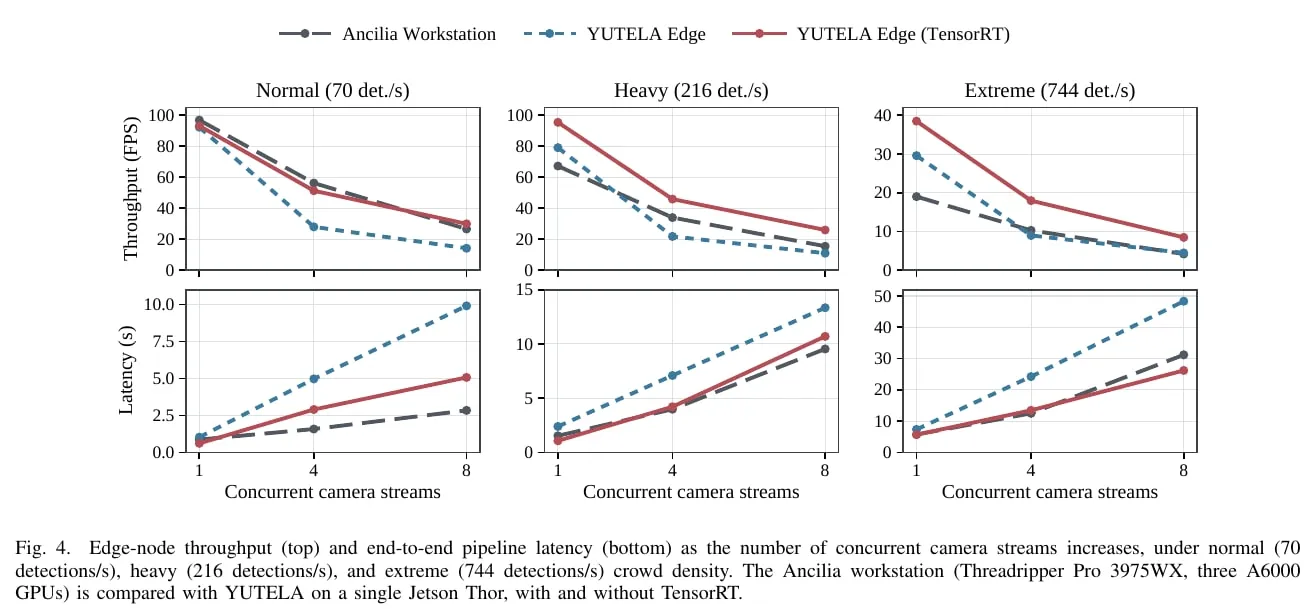
图注:图 4,PDF 物理第 8 页:三种负载下的吞吐与流水线延迟。保留完整坐标、图例与图注,吞吐更高不代表延迟总是更低。 来源:Yao 等,YUTELA,CC0。(YUTELA,arXiv:2610.26468v1,CC0,来源:论文)
图 4 上排是吞吐,下排是流水线延迟,横轴为并发摄像头数;三列负载分别约为每秒 70、216、744 次检测。先比较蓝色与红色:两者同为 Thor 上的 YUTELA,区别是 TensorRT,因此能较干净地检验加速效果。再比较红色与灰色:后者是三块 A6000 的 Ancilia 工作站,硬件、模型和软件同时改变,不能当作纯软件消融。〔§V-A〕
以八路输入为例,原文给出:
| 负载 | 未加速 YUTELA 吞吐 | TensorRT 吞吐 | Ancilia 吞吐 | TensorRT/Ancilia 延迟 |
|---|---|---|---|---|
| 正常 | 14.17 FPS | 29.94 FPS | 26.60 FPS | 5.07/2.84 秒 |
| 较重 | 10.97 FPS | 25.97 FPS | 15.48 FPS | 10.70/9.54 秒 |
| 极重 | 4.47 FPS | 8.48 FPS | 4.18 FPS | 26.19/31.19 秒 |
这里 FPS 沿用受控实验口径,不擅自改写成每相机帧率。正常负载下,TensorRT 相对未加速版本提升约 111.3%;相对工作站仅约 12.6%,且延迟高 2.23 秒。极重负载下,吞吐约为工作站的 2.03 倍,延迟才同时更低。这些差值由 §V-A 数字直接计算。
作者把高人流下收益扩大解释为逐人姿态与异常推理更受益于加速,这是合理解释,但没有逐算子计时来完全隔离原因。九个设置中七个吞吐领先,仍不能推出能耗、成本或任何负载下响应时间都领先;本文也没有给出足以量化整机能效的测量。
实验二:170 小时证明运行闭环,不证明重训更准
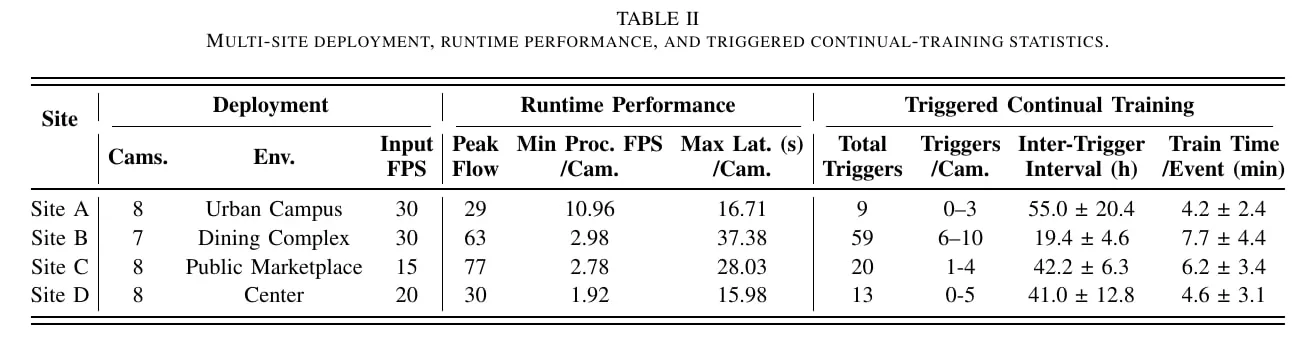
图注:表 II,PDF 物理第 8 页:四站点运行与重训统计。表内最低处理帧率、最高延迟是运行极值,不是均值或告警延迟。 来源:Yao 等,YUTELA,CC0。(YUTELA,arXiv:2610.26468v1,CC0,来源:论文)
表 II 的阅读重点不是只看相机数,而是同时看输入帧率、人流、最低处理速度和最高延迟。八路 30 FPS 的 A 站最低每相机处理率为 10.96 FPS;七路、同为 30 FPS 的 B 站降至 2.98 FPS,最大流水线延迟达到 37.38 秒。相机更少却更拥挤,仍可能更慢。这里“最低/最高”是运行极值,不是均值,更不是告警延迟表的同一指标。〔§V-B、表 II〕
C 站输入为 15 FPS,推理采用固定 30 帧批次;相较 30 FPS 输入,凑齐一批约多等一秒。这个案例说明:降低输入率不必然降低端到端等待,必须同时调整批处理设计。图 5 的运行曲线进一步把人流节律与处理负载放在一起,但相关性不能单独分离所有因果因素。
四站累计 101 次训练,A/B/C/D 分别为 9/59/20/13 次;平均触发间隔分别为 55.0、19.4、42.2、41.0 小时。训练频率确实随有效观察变化。作者估计这些训练占一块 GPU 观察时间的约 6.6%,但“可支持数十站点”是线性容量推算,未计数据上传和同时触发的尖峰,不能当作已完成的大规模部署结果。〔§V-B、§V-D〕
尤其要注意表 I 中 SPARTA 的 HuVAD 64.9 AUC-ROC:它是引用的算法性能,不是四站点适应后的新实测。本文没有提供各站更新前后的帧级/事件级 AUC 或 AP,也没有建立可用于证明误报下降的逐相机人工真值。
实验三与边界:从摄像头到告警,仍是秒级
§V-C 在各站繁忙时段分别触发对象和行为异常,每种场景重复 15 次,报告均值、标准差和范围。A 站两类告警为 6.82±0.57、8.71±0.63 秒;B 站为 11.33±0.69、15.41±0.74 秒。这里测量完整处理路径,不只是神经网络前向,所以更接近用户真正等待的时间。〔表 III〕
但历史 Ancilia 的场地、摄像头和交通条件不同,不能拿两个均值相减就称为算法提速。论文没有把每种被触发事件的识别难度、误报漏报率和这些延迟联合报告;“很快给出一次正确告警”也不能代替全面检测质量评估。
这篇论文没有提供足够的标注失败案例图,不应伪造。可确认的失败边界是:高负载下延迟明显上升;伪正常数据可能吸收漏检异常;有效姿态依赖上游检测和跟踪;一周、同城四站的结果尚不能覆盖季节变化、网络中断和长期模型漂移。前三项分别有运行或作者讨论依据,后两类扩展条件在本文未验证。
研究启发与复现重点
最有价值的下一步不是再堆模块,而是把运行效率与适应质量放在同一时间轴:保存每次更新前后的固定标注集结果,同时记录告警延迟分布、排队时长和训练数据污染。这样才能区分“系统更忙”“模型更新更多”和“检测真正变好”。
复现应优先锁定相机输入率、30 帧批次、检测密度口径、SPARTA 分支及归一化、伪正常阈值、更新计数与清空规则、TensorRT 精度和并发配置。原文未完整说明的项需向公开实现或后续材料核验,不能用默认值补齐。总体判断是:YUTELA 给出了值得研究的部署方法和现实负载证据,但它的强项是“能怎样运行”,不是已经证明“越运行越准确”。
原文与对照来源
- YUTELA,arXiv:2610.26468v1,2026-10-19;全文。图表均来自该 CC0 论文,截图注明物理页码。
- Ancilia,arXiv:2301.03561:核对既有流水线及异常检测能力。
- SPARTA,arXiv:2408.15185:核对姿态评分器职责,不移植未确认的部署参数。
- 周期适应前作,arXiv:2603.04723:核对继承关系,不用其零售结果替代本篇证据。