先说判断:局部扩散的价值,不是把异常也画得更清楚
MA-PDM把视频异常检测做成“用正常视频训练、预测下一帧、再检查预测误差”的任务。值得关注的不是换上扩散模型本身,而是把局部像素预测、位置相关正常记忆、外观与运动两类条件接在一起:既避免小目标被全帧特征稀释,又试图限制异常外观被过度泛化。最有说服力的证据是随机局部裁剪及条件消融,而不是一句“生成能力更强”。主要保留意见同样明确:局部化仍会漏掉远处小目标;报告的吞吐不能直接等同单路实时报警;有些表格差异不足以支持稳定领先。
本文精读 Hang Zhou、Jiale Cai、Yuteng Ye、Yonghui Feng、Chenxing Gao、Junqing Yu、Zikai Song、Wei Yang 的 Video Anomaly Detection with Motion and Appearance Guided Patch Diffusion Model。依据arXiv 2412.09026v1,首发与当前版本均为 2024年12月12日,页面注明 AAAI 2025;这是旧论文重读,不是本周新稿。近期候选未满足本次深读与材料使用条件,因此按既定规则扩展选题。主文为 CC0;另核对作者仓库的补充材料,本文不复制补充图。
从六帧视频走到一个异常分数
训练只用正常视频。每帧缩放至256×256,用前六帧预测第七帧:第一帧提供外观,相邻六帧的五组差分提供运动。三种内容——外观、差分、加噪目标——必须按同一空间坐标裁成64×64块,否则条件与预测对象会错位。训练时随机裁剪,推理时滑窗覆盖全图。主文§3.1—3.4、§4.1
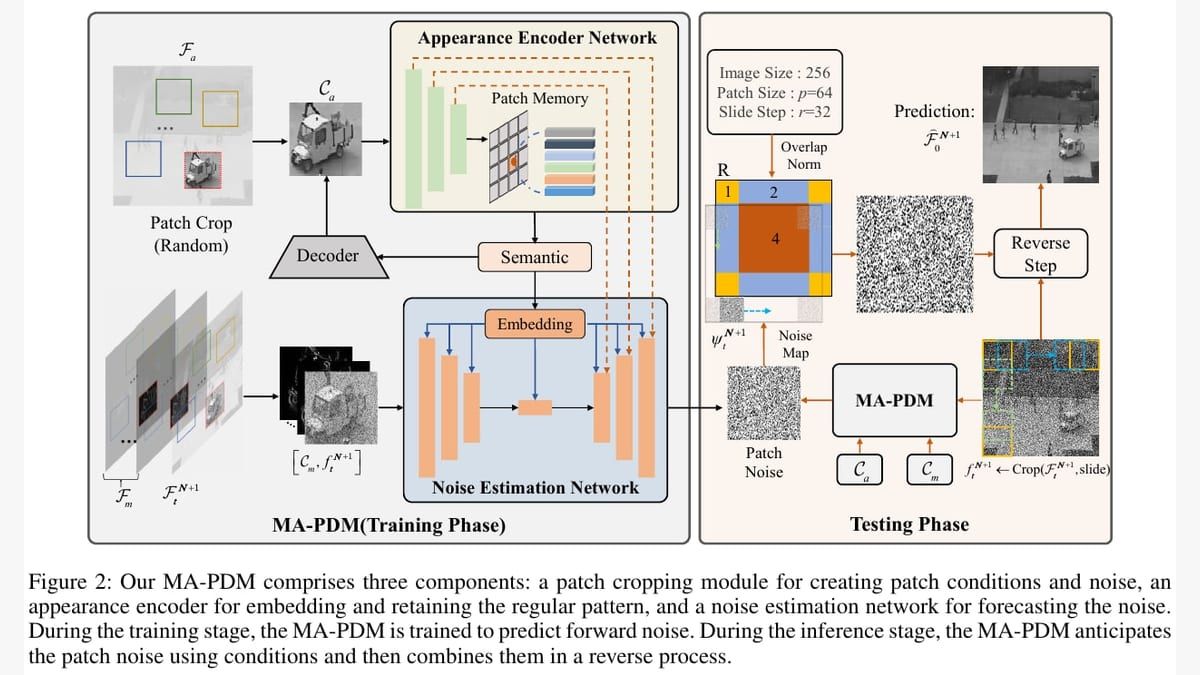
图注:原文图2,PDF第3页,作者Hang Zhou等,CC0;仅裁去无关版面。左侧区分外观记忆与去噪输入,右侧先融合噪声再反向更新。示意步长32,而默认实验步长64;图本身不证明在线性能。(MA-PDM(2024),图2,PDF物理第3页,CC0,来源:论文)
看架构图左侧:外观编码器同时产生多层特征和记忆检索后的语义;差分与带噪目标则送入去噪U-Net。右侧不是独立生成若干最终图片后简单拼贴,而是在每一个反向步骤先汇合各块预测的噪声,再更新整幅图。图中示意步长32,不是最终实验采用的64;这一差别会改变重叠量、速度和显存。
训练优化噪声预测、外观编码与可学习记忆,不是调用冻结VLM打分,也不是拿异常视频提供类别标签。去噪目标是预测人为加入的高斯噪声;外观支路另用重建误差约束正常记忆。总目标为原文式(11)的 L=L_p+0.1L_r。测试从高斯噪声开始,使用5步DDIM反向采样生成第七帧,并重建第一帧。式(16)把两项误差相加:
异常分数=MSE(真实第七帧,预测第七帧)+α×MSE(真实第一帧,重建第一帧)
α在Ped2、Avenue、ShanghaiTech、UBnormal分别为0、0.2、0.3、1。因此Ped2的最终分数不直接包含外观重建误差,但外观仍作为生成条件参与;不能把α=0解释为删除整个外观模块。评分还必须等第七帧实际到达才能计算,不是提前知道未来是否异常。主文式(16)、§4.1
三个设计究竟各解决什么
一、时间差分是条件,不是异常答案
对固定摄像头,相邻像素差可以突出变化,而无需额外运行光流网络。式(3)实际采用前帧减后帧;复现时不宜随意换成绝对差或倒置符号。差分和带噪目标在输入端拼接,作用是告诉生成器“最近怎么变化”,而不是把运动大直接判成异常。这样既可能识别运动模式偏离,也保留通过外观发现静态异常的机会。
直接替代方案是RAFT光流。表5给出Ped2 93.7→98.6、Avenue 88.7→91.3,换成差分分别增加4.9、2.6个百分点,报告吞吐25→45 FPS。这支持本配置下差分兼顾效果与成本,却不能证明差分普遍优于光流:光流质量、域适配和条件编码都会影响结果。另一面,摄像头抖动和光照变化也会造成像素差;这是由表示形式推导的风险,而不是本文已经做过的鲁棒性实验。主文§3.2、表5
二、位置记忆限制“什么外观算正常”,但不是硬保证
外观编码器得到多层特征 h₁…hₙ,最深层作为查询,从对应空间位置的记忆中检索键和值。式(8)可直观理解为:当前图块提出问题,所在区域的正常模板给出加权回答。记忆总尺寸16×64×256,对应16组位置记忆、每组64个256维条目;不要把中间的64和六帧输入混为一谈。
记忆过滤后的语义经池化,与扩散时间步嵌入一起调节U-Net残差块的缩放和偏置。与此同时,多层外观特征通过相加与拼接进入解码路径,保留较细的空间信息。两条通道分别偏向正常语义和分层细节,而不是重复输入同一张图片。式(10)的要点可写成 (1+scale(t+语义))×h+bias(t+语义);这里t是扩散噪声时间步,不是视频帧号。主文式(7)—(10)
最直接的替代是全局共享记忆。表4中ShanghaiTech无记忆77.9、全局记忆78.7、位置记忆79.2;Avenue相应89.9、90.2、91.3。位置化在这些比较中有收益,但全局记忆容量更大,实验不是严格等参数控制,不能只把差异归因于空间先验。我的进一步判断是:位置记忆适合固定机位,却可能把场景布局绑定得更紧;换机位能力需要额外证据。
三、按块学噪声,而不是先检测对象
默认64步长与64块大小相等,实际不重叠;较小步长才进入重叠情形。相较对象中心方法,规则图块不依赖检测器找到所有前景;相较整图生成,随机图块增加局部训练样本,让小区域误差不完全淹没在背景中。这一选择沿用了已有图像恢复中的分块扩散思路,新的工作在于与VAD的运动、外观及位置记忆组合,而不是首创扩散或记忆机制。
推理时若块有重叠,需要把同一像素的噪声估计按覆盖次数归一化;否则重叠越多,噪声幅度就越大。原文式(13)的简写应结合覆盖矩阵理解,实际实现须确认累加而非覆盖。论文式(16)以整帧MSE定义评分,不是最大异常图块投票,所以局部建模增强不自动消除小目标在整图平均中的稀释问题。主文§3.3、§3.5
与最近路线相比,MNAD已有正常原型记忆;FPDM已有运动、外观两阶段特征扩散。后者还将当前目标帧的加噪特征作为恢复输入,不能与从纯噪声预测下一帧的MA-PDM混为一谈。MA-PDM新增的是像素图块、位置记忆和多层条件的结合,不是首次使用扩散或记忆。
实验:把表格拆成可检验的主张
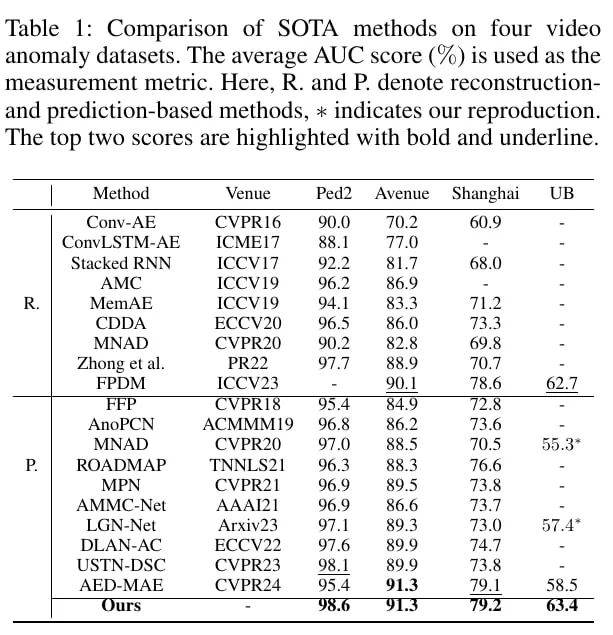
图注:原文表1,PDF第6页,作者Hang Zhou等,CC0;帧级ROC-AUC(%,越高越好),仅裁去无关版面。注意Avenue与AED-MAE持平;ShanghaiTech相对FPDM为79.2-78.6=0.6个百分点,不是正文所写0.5。(MA-PDM(2024),表1,PDF物理第6页,CC0,来源:论文)
主表报告帧级ROC-AUC百分数,不是分类准确率或事件召回率。四列依次为Ped2、Avenue、ShanghaiTech、UBnormal;MA-PDM为98.6、91.3、79.2、63.4。对FPDM,后三列提升为1.2、0.6、0.7个百分点:ShanghaiTech由78.6到79.2,正文写的0.5与表中算术不符,本文采用可复算的0.6。对AED-MAE则为+3.2、持平、+0.1、+4.9;因此“所有数据集严格超过所有方法”不是表格支持的结论。主文表1、§4.2
还要限制比较范围:这是论文当时所列方法,不是2026年的最新排行榜。AED-MAE采用合成异常的设置,与本方法正常视频训练路径不同;表内星号只标了部分作者复现值,其余不能假定统一重跑。未报告随机种子方差时,ShanghaiTech的0.1个百分点只能称表中小幅差异。主文只写帧级AUC;公开代码则逐视频处理后拼接分数、计算全体帧ROC-AUC,是micro式汇总而非逐视频AUC平均。代码与论文配置仍有差异,复现不能只凭同名指标宣称完全一致。
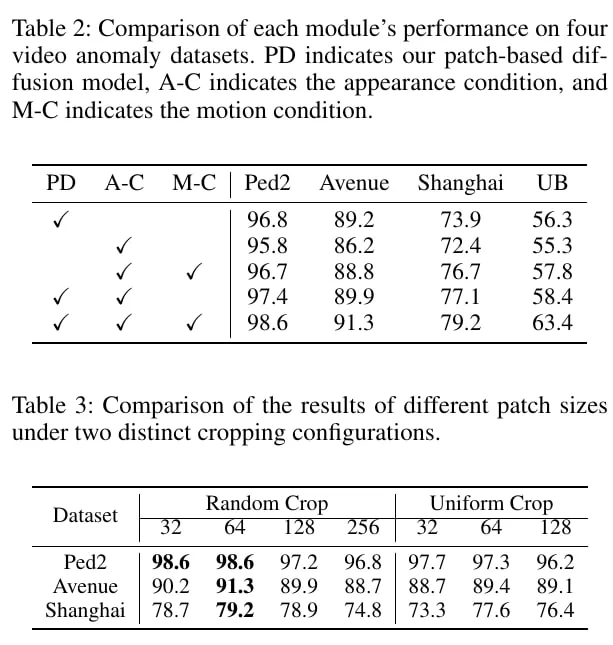
图注:原文表2、表3,PDF第6页,作者Hang Zhou等,CC0;帧级ROC-AUC(%,越高越好),保留模块定义与多级列标题。上表支持条件逐步加入的收益,缺少仅运动的完整对照;下表将尺寸与训练裁剪方式分开比较。(MA-PDM(2024),表2—3,PDF物理第6页,CC0,来源:论文)
先看表2后三个相关配置。仅图块扩散到加入外观,ShanghaiTech由73.9升至77.1;再加运动升至79.2。四个数据集的最后一步增量分别为1.2、1.4、2.1、5.0个百分点,支持在已有外观条件上加入运动有用。不过缺少“图块扩散+运动、无外观”的对应行,尚不能完整分离两种条件的独立作用及交互。只含外观的一行还是MNAD式对照,不应当成只关闭某个开关、其他结构完全不变。
再看表3,随机64块在ShanghaiTech为79.2,整图256为74.8,差4.4个百分点;相同64尺寸随机裁剪又比均匀裁剪77.6高1.6个百分点。因此“局部尺度”和“训练采样多样性”都有证据,不能把全部收益归给更小感受野。32块并未继续提高ShanghaiTech,Ped2的32与64同为98.6;最佳尺度与目标大小有关,不存在越小越好的单调规律。表3实际只列三个数据集,正文关于“四个数据集”的表述不能补出UBnormal的缺失数值。
看完补充材料,部署判断需要收紧
主文图3展示部分视频的分数曲线,说明模型在选定正常时段更平稳、异常时段更高;它不是全测试集误报率证明。作者补充材料还明确展示远处清洁人员、朝镜头移动的小自行车等失败例。它们恰好限制了“分块解决小目标”的叙述:分块有所帮助,不等于尺度与远近问题已经解决。
补充报告45 FPS对应A100 40GB、batch=16,4090 24GB为40 FPS;缩小滑窗步长会明显增加显存并降低吞吐。不能由此推成单帧延迟或任何设备都实时。补充对UCF/XD还重新划分、筛选原测试视频,不是标准弱监督全测试协议,本文不拿这些数值与标准榜单横比。
进一步核对公开代码固定版本5877dec,每段预测对齐第七帧,前六帧不进入这条评测路径。预测输入没有显式读取此后帧;但评分后调用utils.py中的filt,长度37的滤波核两侧补18个零,当前输出会混入后18个预测分数。因此不能称整个评测链严格在线:生成阶段仅用此前六帧条件,后处理却使用未来信息。
该路径默认normalized=False,不能因为文件里存在min-max函数便声称使用了整视频归一化。另一处值得警惕的是score_sum固定权重[1,0],与论文分数据集的α不同;这是公开快照与论文描述的配置缺口,不是我们复跑后证明表格有误。计时也只包围diffusive_restoration调用,未把外部装载、后续MSE和平滑等统一计入。部署评测应重新计时,而不是将生成吞吐当摄像头管线吞吐。ROC-AUC只说明阈值扫描下排序能力,无法直接告诉我们每小时会响多少次警报。
值得复现的不是一句SOTA,而是三个控制实验
首先固定网络和评分,仅改变64图块与256整图,检查4.4个百分点收益能否重现;再固定图块尺度比较随机与规则训练裁剪,避免把数据增广收益算成架构收益。其次补齐“仅运动”的缺失条件行,并对全局、位置记忆做等容量比较。最后用固定阈值报告单路延迟和每小时误报,同时区分远处小目标与普通尺度事件。这些是本文分析提出的后续实验,不是作者已经给出的结果。
实现时先锁定六帧条件、带符号差分、同坐标裁剪、16×64×256记忆、1000步训练噪声日程和5步采样,再核对α及误差时间归属。不要先调出更漂亮的预测图便宣布检测更好:异常也被预测准确时,误差检测反而可能失去信号。本文的贡献证据支持“条件化局部生成值得做”,还没有支持“泛化可靠、随处实时的小目标报警器”。
来源与阅读范围
- 主文及版本记录、完整HTML:阅读全文9页及表1—5、图1—3;图表按CC0标注来源,截图仅裁去无关版面。
- 作者代码仓库与4页补充材料:核对结构、效率设置及失败例;本文为论文证据分析,未独立训练或复跑模型。