正常不是只有一种未来
一个人在路口继续直行或转身,都可能正常。如果预测器只能给出唯一的未来,实际动作与预测不同便会产生大误差,把“另一种合理选择”误当异常。MoCoDAD把问题改成:给定已经发生的动作,生成一组可能的后续轨迹,真实后续是否至少接近其中一种?
本文精读ICCV 2023论文《Multimodal Motion Conditioned Diffusion Model for Skeleton-based Video Anomaly Detection》,依据2023年8月28日arXiv v3,包含补充材料。这里的multimodal指运动分布有多个模式,不是音频、视频、文本融合。它只用正常训练姿态,属于单类学习;但最终异常评分必须拿实际发生的后续姿态与生成结果比较,不能据此宣称提前预知事故。
核心判断是:论文把生成多样性与检测判别性分开了,最有价值的实验并非“扩散可以生成漂亮动作”,而是证明单看多样性不行,选择最贴近真实未来的生成结果更有用。边界在于姿态表达、时间回填,以及多次采样带来的成本和评分偏差。
与单中心方法的差别:保留选择,而不只是缩小正常区域
必要对照COSKAD原论文用图编码器和投影头,将正常骨架嵌入收缩到潜在空间的一个中心附近,通过距离衡量异常;它探索欧氏、球面和双曲空间。MoCoDAD并不证明这些空间一定无法表达复杂正常运动,而是选择另一条路线:显式生成条件分布中的多个可行未来,再检验观测与候选集合的关系。
因此,不能简单说“旧方法只有一种正常动作,新方法懂所有动作”。编码器可以把复杂输入映射到紧凑区域,生成模型也可能漏掉训练稀少的模式。两条路线的区别是优化对象:一个直接塑造正常表示的几何,另一个训练有条件的生成过程,并把生成误差转换成异常分数。(MoCoDAD§2—3;COSKAD原文§3)
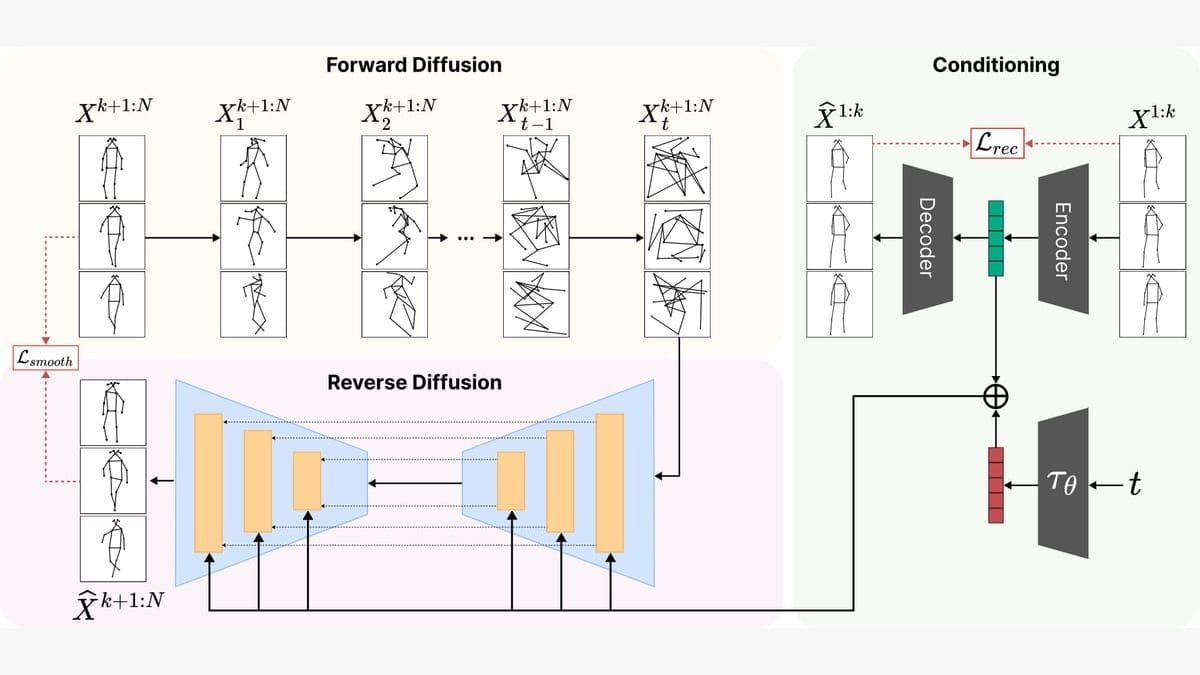
图注:图2:只对未来姿态加噪,以过去动作和扩散时间共同约束去噪。生成未来与验证异常是不同阶段。 来源:Flaborea等,arXiv:2307.07205v3,图2,CC BY 4.0(来源:论文)
方法一:只破坏未来,让过去成为约束
模型处理一个人的连续二维骨架,把序列分成干净的过去与待生成的未来。实际实现使用6帧窗口,前3帧作为条件,后3帧参与扩散。训练时,给未来关节坐标加入高斯位移噪声;噪声程度由扩散时间步决定。去噪网络同时接收被扰动的未来、时间步嵌入以及过去动作编码。
这与直接重建完整输入不同:过去保持可读,模型必须借它约束未来,而不能仅靠尚未破坏干净的目标泄露答案。训练使用位移估计损失的平滑形式,小误差区近似二次、大误差区近似线性;另外对过去编码加入重建约束。原文公式与补充伪代码分别以噪声估计和预测样本描述训练,独立实现时应核对官方代码中的参数化,不能把两种目标直接当作同一个张量操作。
推理从随机噪声出发,通过多步去噪得到未来骨架;更换随机性,生成多个候选。这里重要的不是图像清晰度,而是这些候选是否覆盖条件所允许的正常变化。每个候选与真正发生的未来计算平滑重建误差,形成一组误差,再汇总成单人窗口分数。
过去可能本身异常,但模型仍能生成多样动作。作者希望正常条件下的候选更贴近真实后续,异常条件下虽有多样性,却不容易匹配实际后续。这是经验性区分假设,不是“异常输入必然无法生成”的数学保证。(主文§3.1、补充A、C)
方法二:条件怎样送进去,比“用了扩散”更具体
论文比较三种条件策略。第一种把干净过去与噪声未来直接拼接,让网络自己保持过去信息。第二种先编码过去,将嵌入送到去噪网络各层,但编码器仅由主任务端到端训练。第三种额外加入解码器,要求过去嵌入还能重建原来的过去,从而减少条件信息在压缩中丢失。
第三种AE-embedding是最终选择。总目标结合去噪损失和过去重建损失;补充实现将两项权重都设为1。不要把这个辅助重建误认为使用异常标签:它仍从正常姿态自身产生监督。但也不要把“编码更好”当成已证明的信息论结论;实验只说明这个附加约束在所测数据与配置下提高了检测成绩。
结构上,条件编码器和去噪器都使用时空可分图卷积。去噪器呈U-Net形,压缩再恢复关节维度,带对称残差连接;过去编码与扩散时间嵌入相加后,投影到每层所需维度。补充实现从17关节压缩到10,通道逐步变化。过去3帧不是一个只在开头出现的提示,而是多层反复可用的约束。(主文§3.2—3.3,补充E)
方法三:三个不同层级的汇总,不能只写一个最小值
生成候选之间,论文发现最小误差总体最好,可写成:
$$h_a=\min_{j=1,\ldots,m}\ell\bigl(Z_{a,j},X_a^{future}\bigr).$$
它表示“至少有一种生成未来解释了观测”。随后,同一演员在重叠时间窗口中的分数又取最大值。最后,多人同帧不是简单平均:主文有平均的简述,补充算法C给出了更完整的范围修正:
$$AS=\operatorname{mean}(S)+\log\frac{1+\max(S)}{1+\min(S)}.$$
第二项利用不同演员得分的跨度,避免极端高分完全被多人平均淹没。这三个层级分别是候选、重叠窗口与演员,不应混用;若只实现“所有重建误差取平均”,已经不是论文实际描述的评分流程。
最小误差也有代价。候选越来越多,总有更大机会偶然接近目标,正常和异常的最小误差都会倾向下降。论文观察到它改善排序,不等于该数值在不同采样数量下天然可比,更不等于校准后的异常概率。部署阈值必须与采样预算和汇总方式绑定。(主文§3.1、补充C,最后一点为本文分析)
榜单证据:相对提升与百分点要分清
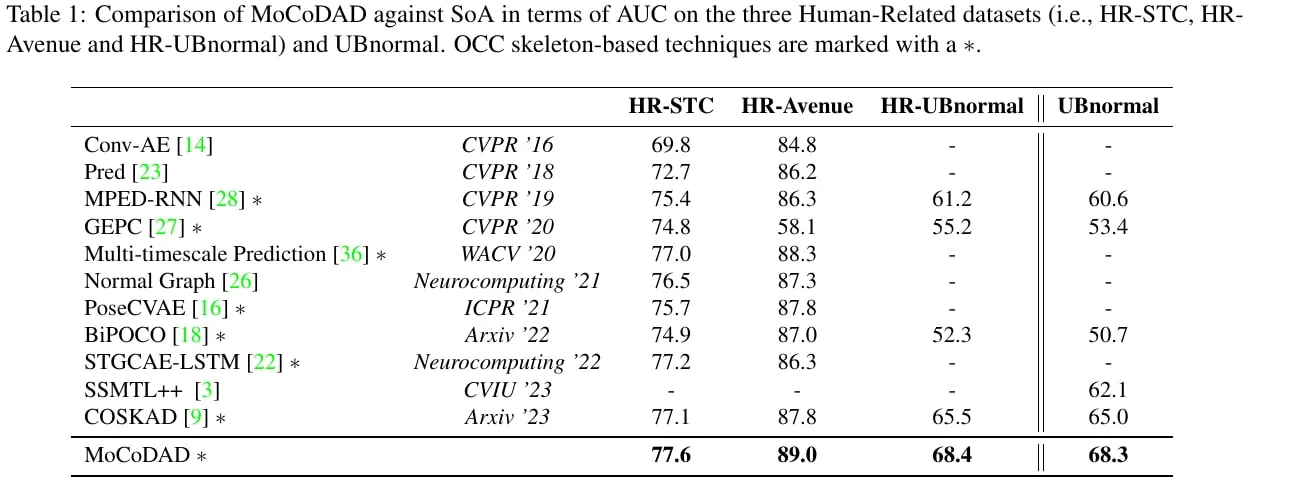
图注:表1:2023年比较范围,保留HR/完整数据集及骨架单类方法标记;不能与完整ShanghaiTech成绩混排。(按原页裁切。)(Flaborea等,arXiv:2307.07205v3,表1,物理第6页,CC BY 4.0,第 6 页,来源:论文)
表1报告HR-ShanghaiTech、HR-Avenue、HR-UBnormal、完整UBnormal的ROC-AUC分别为77.6、89.0、68.4、68.3。HR版本筛除了或特别处理非人体相关异常,不能与完整ShanghaiTech或Avenue结果直接混排。这也是为什么本文不拿这四个数描述今天所有VAD方法的最佳水平:它们属于2023年的论文比较范围。
相对COSKAD,UBnormal从65.0到68.3,绝对增加3.3个百分点,相对增加约5.08%;HR-UBnormal从65.5到68.4,增加2.9个百分点,相对约4.43%。原文提到5.1%与4.4%时,应按相对增幅理解,不能写成增加5.1或4.4个AUC点。HR-Avenue表中最好的既有值88.3到89.0,也只是0.7个百分点。
表2将142K参数的MoCoDAD与121M参数、68.5 AUC的TimeSformer并列,MoCoDAD为68.3。参数量确实相差约852倍,但输入与监督都不同,且骨架提取器未包括在这142K中。参数更少不等于端到端计算少852倍,更不代表实时速度得到同倍率提升。表中不同监督方法仅作背景,不能作为控制变量严密的架构消融。
补充F明确说验证集用于超参数微调,验证AUC77.6不应代替测试68.3。正常样本训练与使用带异常标签的验证评价是两件事。主表没有给多随机种子的置信区间,尤其0点几的差异不宜直接写成统计显著胜出。
最有说服力的实验:多样性不是异常分数
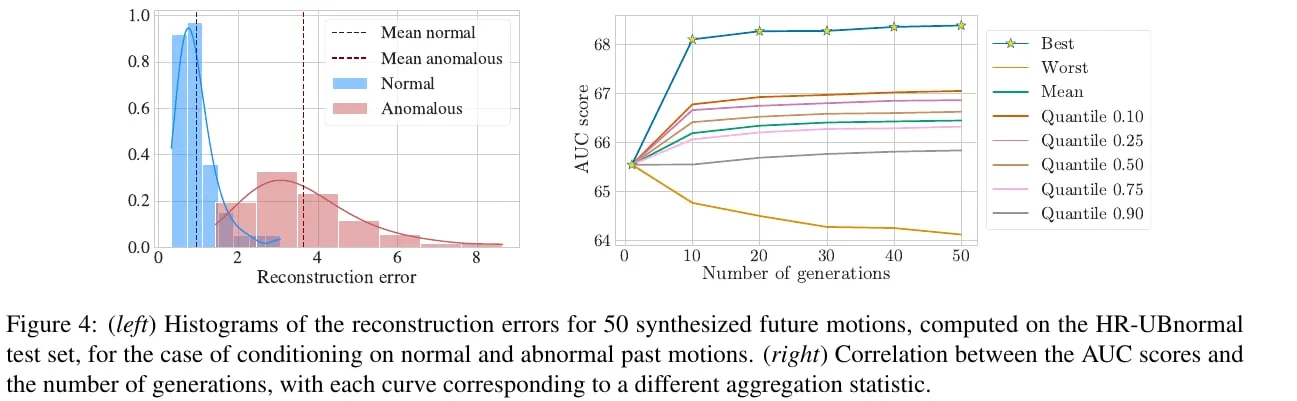
图注:图4:候选增多只在合适的统计汇总下改善检测,最小误差优于直接平均;保留图例和坐标。(按原页裁切。)(Flaborea等,arXiv:2307.07205v3,图4,物理第8页,CC BY 4.0,第 8 页,来源:论文)
图4左侧比较50个候选未来的误差分布,右侧比较不同采样数量及汇总统计。以最小误差评分的检测AUC总体最好,而以最坏误差评分的AUC随候选增加明显下降。这里有一处图文不一致:§5.2称平均值及高分位数与生成数量负相关,但图4中的Mean和分位数曲线并未一致显示这种下降,不能照抄为确定趋势。超过50次后作者报告性能趋于饱和。稳妥结论是采样预算与汇总方式必须一起说明,而不是笼统声称多生成必然更好或更差。
原因直观:正常行为也有很多合法后续,随机选中的一个合法候选可能与实际动作不同,不能因此给高异常值。最小值允许其他合法候选存在,只要求其中一个贴近现实;平均值会让那些合法但未发生的分支贡献误差。
多样性比率rF用平均误差除以最小误差衡量候选差异。论文补充D发现,把这种多样性直接当异常分数,表现接近随机,部分采样数甚至低于随机。正常与异常条件都能产生分散候选,因此“模型犹豫、输出多样”本身不是异常证据。t-SNE示意图帮助理解真实未来处于候选分布中心还是边缘,但二维投影与少数案例不能证明高维密度得到完整覆盖。
消融:预测任务不是越容易越好
表3的条件策略在UBnormal分别为:输入拼接65.0、端到端嵌入64.2、加过去重建约束68.3。只把条件编码送入多层并不足够,辅助重建才与最终改善同时出现。表4中随机补帧65.1、中间补帧65.7,低于预测未来的68.3。作者解释中间补帧有两端信息,可能连异常也容易补好;这是合理机制解释,但不是排除所有优化差异的因果证明。
补充表6更说明检测目标与生成质量不等价:扩散步数2、5、10、25、50时,UBnormal分别64.7、65.9、68.3、64.6、64.4。更多步并不持续提高检测分数。补充表7中,完整高斯采样但不输入过去条件只有54.1,加入条件达到68.3;这支持“与过去相关的未来”比泛泛生成正常骨架更重要。
表5的潜空间版本也没有获胜:MoCoDAD+MLD为58.1、Latent-MoCoDAD为62.5,原坐标版本68.3。但这只否定所测潜空间与训练配置,不应扩大成“骨架扩散永远不能降维”。后来的不同表示设计必须重新实验,而不能被一次负结果排除。
未来帧、成本与上游失效:上线前还有哪些空白
算法将窗口得分赋给窗口内各帧,并在重叠窗口中汇总。这包含利用后续真实姿态回看较早帧,不能叫零延迟因果报警。如果在窗口结束才输出,系统可以做延迟检测,但应明确等待长度;本文评分需要真实未来,预测的是候选动作而非提前给出已验证的异常结论。
正文及补充没有给足够清晰的逐视频归一化、时间平滑和端到端延迟说明,本文不自行补齐。复现需要从官方实现锁定这些细节,分别报告原始因果分数和离线后处理成绩。补充给出Quadro P6000上约7小时训练,但这不是推理时延;多候选、多去噪步及每人每窗口处理都产生计算,不能仅凭142K参数保证实时。
作者强调骨架不含外观纹理、有利于减少视觉身份信息;本文保留的推断是,系统上游仍可能先处理原始人像,不能称作形式化匿名化保证。遮挡、错关联、演员未贯穿整个窗口,以及靠物体才能判断的异常,也是本文从算法输入提出的风险,论文并未系统量化这些失败率。
值得延续的研究问题,是在固定总采样预算下,能否保持正常多样性的覆盖,同时避免异常偶然匹配某个候选。应同时看每小时误报、事件召回与检测延迟,而不只看AUC。MoCoDAD的真正启发是允许正常拥有多个答案,再检验现实是否被合理解释;它没有把“可以生成”自动变成“可以可靠报警”。
来源与许可
论文版本、完整正文与补充,首次提交2023年7月14日,本文使用8月28日v3,ICCV 2023。官方HTML明确CC BY 4.0,图2、表1、图4均据该版本转载并保留出处。阅读覆盖§1—6与补充A—H,未独立运行代码。
必要基线:COSKAD早期原文,用于核对收缩正常潜在表示的设计;数值比较采用MoCoDAD表1所列版本,不与后来的期刊改版成绩混合。