MOVAD 精读:异常检测不能只问“哪一帧”,还要问“多久报警”
本文精读 Doshi 与 Yilmaz 的《A Modular and Unified Framework for Detecting and Localizing Video Anomalies》,以 2021 年 3 月 21 日公开的 arXiv v1 全文为数字基准。它不是后来另一篇同名缩写的交通视频 MOVAD。以下是论文证据与独立分析,不是运行代码得到的复现结果。
一、问题:帧级排序与及时报警不是同一件事
假设两个检测器在同一异常事件里都认对一半帧,一个在事件开始就报警,另一个等事件快结束才报警。帧级排序指标可能接近,人的处置机会却完全不同。MOVAD 最有价值的贡献,是把“离线找到异常帧”和“在线发现异常事件”分开设计,而非只换一个视觉骨干。
还有更隐蔽的协议问题:许多方法用整段测试视频的最大、最小分数做归一化。离线分析可以这么做,但实时监控尚未看到视频结尾,无法知道未来极值。网络能逐帧计算,不代表最后的报警流程就是因果在线系统。这篇论文把归一化、时序积累和报警阈值都摆到了台面上。
它采用正常样本建立参考分布,原文称为半监督设置;不应与使用异常视频标签的弱监督混淆。视觉模块借用外部有监督预训练知识,因此也不是从零开始、完全不使用标签。设计目标是让正常分布和决策层容易更新,而不是每换摄像头都重新训练整个视频网络。
二、设计:视觉知识与报警规则分工
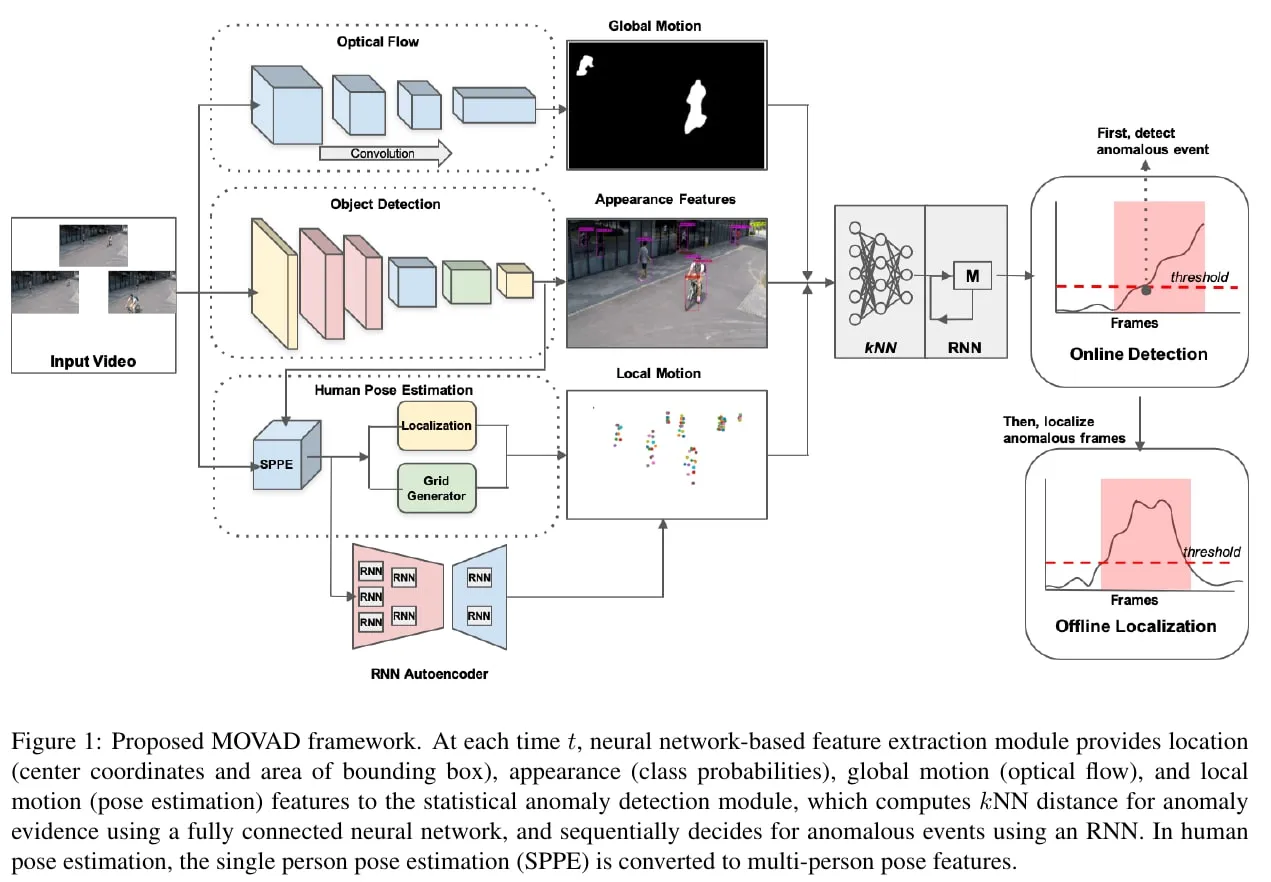
图注:Doshi 与 Yilmaz,Figure 1,arXiv:2103.11299v1,CC BY 4.0。框架接口与具体18维配置需分别阅读。(按原页裁切。)(Doshi与Yilmaz,MOVAD v1,CC BY 4.0,第 3 页,来源:论文)
框架先从每个目标提取特征,再估计它偏离正常数据的程度,最后跨时间积累证据。图中展示位置、外观、全局运动和人体局部运动四类接口;具体实现则需要按正文的配置读取,不能把框架示意的所有字段自动算进实验输入。
外观来自 COCO 预训练 YOLOv4 的类别概率;运动来自预训练 FlowNet 2 光流;人体姿态来自 AlphaPose。正文实现细节说明每个对象使用十八维向量:十五个类别概率、框内光流均值与方差,以及人体姿态预测误差。这里并未列入图中提到的框中心与面积,属于架构描述与具体配置之间应保留的差别。运动特征使用训练数据的最小、最大值缩放,不需要整段测试视频的未来极值。(原文第 3.2–3.3 节,PDF 第 3–5 页)
特征不是异常语义本身。类别偏离可以提示出现陌生对象,运动统计变化可以提示异常速度,但无法直接证明行为危险。类别识别错误、遮挡或摄像头移动,同样可能造成偏离。可解释的接口只是更容易追查分数来源,并非自动建立了人类语义上的因果解释。
接着,对每个对象计算它到正常训练集合中第 k 个近邻的欧氏距离。原文取 k=10。直接检索会随正常样本规模增长而变贵,作者用三个隐藏层、每层二十个神经元的全连接网络回归近邻距离,训练目标为距离预测平方误差加正则。这样推理不必每次遍历全部参考点,但近似误差也成为额外风险:正常样本上的回归准确,不保证训练分布外距离仍可靠。
一帧存在多个对象时,取其中最大的估计距离作为该帧证据。这可以保留小范围异常,却也让单个误检目标支配帧分数;检测人数改变后最大值的统计分布可能变化。后面的时序积累只能缓解偶发噪声,无法从根本上修复持续误检。
从单帧尖峰到累计证据
一般版本用带内部状态的 RNN 汇总距离。因为训练时缺少真实异常距离,作者从正常距离分位点到两倍正常最大距离之间均匀生成合成距离,帮助训练决策器。这里生成的是数值证据,不是合成异常视频,更不能称为已学习全部异常行为。
简化版本固定内部权重,更新为 s_t=max(s_(t-1)+δ_t,0);其中 δ_t=D_t^m−D_α^m,m 为特征维数,D_α 来自正常训练距离分位点。正常证据通常让累积值回落到零;持续偏大的距离则逐步推高它,越过阈值 h 后报警。这与 CUSUM 式变化检测相似,直观上是在要求异常证据具有持续性,而非见到尖峰就通知。
代价是报警延迟。阈值高通常更能压制误报,也需要积累更久。作者给出大样本极限下的误报率上界,并用训练统计量构造 h。必须强调:这是简化检测器的渐近理论,不是任意视觉误差、任意场景漂移下的产品级误报保证。本文已读取主文公式及有限样本实验,但补充证明链接访问受阻,未独立验证证明细节;因此不扩展其适用条件,也不声称完成理论复现。
三、实验:把三种收益分开看
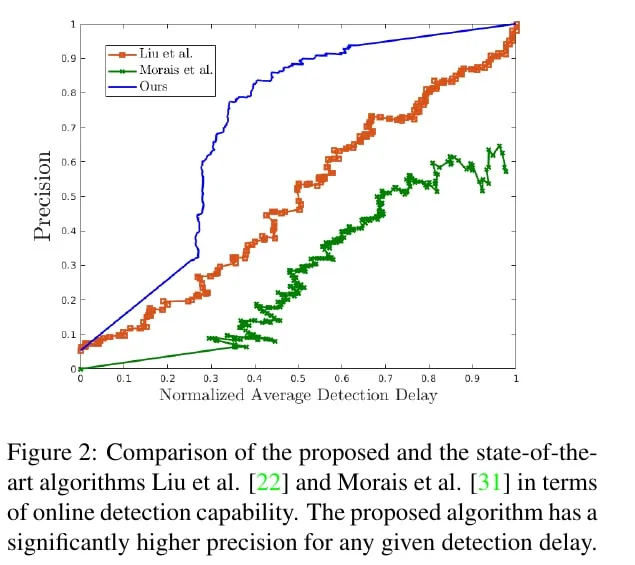
图注:Doshi 与 Yilmaz,Figure 2,arXiv:2103.11299v1,CC BY 4.0。该在线曲线不是帧级 ROC。(按原页裁切。)(Doshi与Yilmaz,MOVAD v1,CC BY 4.0,第 6 页,来源:论文)
在线检测使用 APD,即精确率随归一化平均检测延迟变化的曲线面积;它不是常见的 precision-recall AP,也不是帧级 AUROC。原文将平均延迟按最大允许延迟或视频自然片段长度归一化。部署者需要保留这一定义,否则同名分数也可能不可比较。
以下按原文 Table 1 重排,均为 ShanghaiTech 在线评价:
| 方法 | APD |
|---|---|
| Liu 等预测基线的在线版本 | 0.504 |
| Morais 等骨架方法的在线版本 | 0.324 |
| Luo 等方法的在线版本 | 0.447 |
| MOVAD | 0.705 |
MOVAD 相对表内最佳比较项增加 0.201;这是 APD 的绝对差,不能说成 AUC 提升二十个百分点。更接近因果检验的是取消时序积累的内部比较:第 4.3 节报告 APD 降为 0.673,差为 0.032。这支持积累机制有帮助,同时提醒我们,完整方法相对外部基线的全部收益不能都归功于时序规则。
作者只在 ShanghaiTech 做这组在线评价,理由是另外两个常用数据集的异常事件少于五十个。这个选择避免了小事件数下不稳的平均值,却也限制了结论范围。它不是跨所有场景验证过的在线检测优势。比较对象还是为在线场景调整的版本,需要区分原始论文指标和这里重新评价的指标。
离线帧级 AUC 的结果则不同。原文 Table 2 给出 Avenue 88.7、Ped2 97.2、ShanghaiTech 73.62;Memory-guided Normality 对应为 88.5、97.0、70.5。前两项差值都只有 0.2 个百分点,不能无视方差宣称巨大进步;ShanghaiTech 的 Multi-timescale Prediction 为 76.03,反而高出 MOVAD 2.41 个百分点。在线决策更好和离线排序最好,本来就不是一个命题。
作者还讨论把所有视频拼接后算 AUC,与先逐视频算 AUC 再平均的差异。两者给视频的权重不同,不能直接混成一张排行榜。论文提到像素定位与帧级指标的联系,但本文不据此把帧级 AUC 当作空间定位能力已经验证:指出异常发生在哪一帧,仍不同于框准异常对象或区域。
少样本适配:是换决策参考,不是凭空获得全部知识
原文 Table 3 定义一 shot 为十帧连续片段,不是一张图片,也不是一段任意长度视频。MOVAD 的一、五、十 shot 结果分别为:Ped2 93.19/95.91/96.01,Avenue 80.18/80.21/80.68,UR Fall 86.11/88.7/91.28,单位是帧级 AUC 百分值。
这些数字有互补含义:Ped2 随样本增加明显改善后趋于平缓;Avenue 从一到十 shot 只增加 0.50,不能概括成更多样本总会大幅提高;UR Fall 增加 5.17,说明适配收益依赖场景。更重要的是,该实验由于数据少,作者只使用光流统计,未有意义地利用外观与局部运动。因此不能把少样本成绩描述成全部十八维多模态系统同时达成。
比较基线 r-GAN 用 MAML 学习快速适应新场景的初始化;MOVAD 借助外部预训练特征重建局部统计参考。两者更新的对象、预训练来源及计算成本不同。这项结果支持一种低数据量适配路线,但不是排除了所有训练条件差异的架构优劣判决。本文对该基线机制的核验来自其原始方法章节,未复跑代码。
四、哪些结论仍应克制
模块实验 Table 4 给出 ShanghaiTech 单独外观、光流、姿态 AUC 为 0.594、0.703、0.652。光流最强并不代表其他模块无用,也不能从单模块结果算出融合的独立贡献;需要成对移除、不同异常类别分层及相同检测质量下的比较,才能解释交互作用。
作者承认缺少异常原因的真值,未能定量评价可解释性;结论也承认某些光流变化不明显的异常姿态仍难处理。这比“能解释一切异常”准确得多。正文以部分可视化展示分数来源,只证明某些例子可以追踪,不能证明解释忠实性和完整性。
工程方面,模块化方便替换组件,但 YOLO、光流和姿态估计的总开销不能因为决策头小就忽略。当前阅读版本没有足够的完整端到端吞吐、硬件与持续流延迟证据,让我们把在线因果性直接等同于满足摄像头实时帧率。在线报警起点之后还要连续观察下降窗口来确定事件终点,这也意味着事件边界输出和首次报警拥有不同等待时间。
我的判断是,MOVAD 值得借鉴的不是一个固定特征清单,而是一套提问方式:分数如何归一化、何时允许报警、误报预算怎样选、错过事件开头要付出什么代价。若复现,我会优先固定事件匹配与漏检处理规则、连续流重置方式及阈值校准集,再比较相同特征下的瞬时阈值和累计检测;这些是建议的后续实验,不是论文已经给出的结果。
还有两条容易遗漏的边界。第一,平均延迟需要决定完全漏检的事件如何计入;若只平均成功检出的事件,漏掉困难事件反而可能使数字变好。因此重用 APD 时必须同时公开事件召回、漏检惩罚、重复报警合并方法,不能只保留一条漂亮曲线。这里是评价协议审查建议,并非指控论文已经出现这种偏差。第二,训练极值归一化虽然不偷看测试结尾,但新场景的运动范围可能超出原范围;是否裁剪、如何处理超界以及何时重校准,都应由实现明确说明。把测试未来信息换成训练统计,只解决了因果性的一部分,并没有自动解决分布漂移。
最后,报警后的适应不宜无条件把近期数据收为正常。如果异常持续较久,自动吸收会把异常变成新的正常基线;少样本场景适配需要可信的正常校准片段。这是从方法假设推导出的部署风险,不是论文报告过的攻击实验。
阅读与图表说明
全文基于 arXiv v1 十页 PDF及对应 HTML。数字定位:在线 Table 1、离线 Table 2 在 PDF 第 6 页;少样本 Table 3 在第 7 页;单模块 Table 4 与去时序实验在第 8 页。原文采用 CC BY 4.0;插图须注明作者与来源。补充证明未成功取得,本文明确保留这项阅读限制,不将未核验理论包装成完整复现。