先说结论:检测收益值得看,因果预警还需要另一套证据
《Enhancing Anomaly Detection with Causal Reasoning and Semantic Guidance》把时序融合、Wikidata语义原型和GRU事件关系预测放进同一个弱监督视频异常检测框架。它报告的检测与定位消融有明确增益,尤其值得研究的是“整段视频标签如何指导局部语义对齐”。但标题中的因果推理和正文中的提前预警,比现有实验能够支持的结论更强:序列预测头不自动等于因果识别,单个因果卷积也不自动使上游全局注意力变为在线模型。
本文依据期刊全文和23页PDF逐节核对。作者为Weishan Gao等,正式卷期发表于2026年1月12日;出版方另有2025年12月3日在线先行版本,不能把它当成最近一周新论文。原文按CC BY 4.0开放,以下为原创分析而非全文翻译。数值均为作者报告,本站未运行复现。
它在已有路线上的位置
与RTFM、UR-DMU等基于视频标签学习异常分数的方法相比,这篇工作增加了类别语义和外部知识。与VadCLIP相比,它不满足于把类别文字与视频特征对齐,而希望把类别扩展为一组相关概念,再形成语义原型。与PE-MIL同样利用异常语义和正常上下文的思路相比,它额外设置事件状态和下一事件预测任务。
因此不能把创新简单概括为“首次引入文本”。更准确的问题是:额外知识是否比类别名称更有用?事件预测任务是否提供了超出普通多任务正则的收益?所谓因果解释究竟由视频时间证据学出,还是由预设知识转移矩阵注入?这三个问题分别对应原型对照、模块消融和监督来源审计。
本文使用的是RGB视频,不使用音频,但不等于只用RGB监督:类别标签、预训练I3D、BLIP文本编码和Wikidata先验都属于必须列明的信息来源。拿它直接与只有二元视频标签的方法比较,不能把差值全归为网络结构进步。
一次完整的数据流
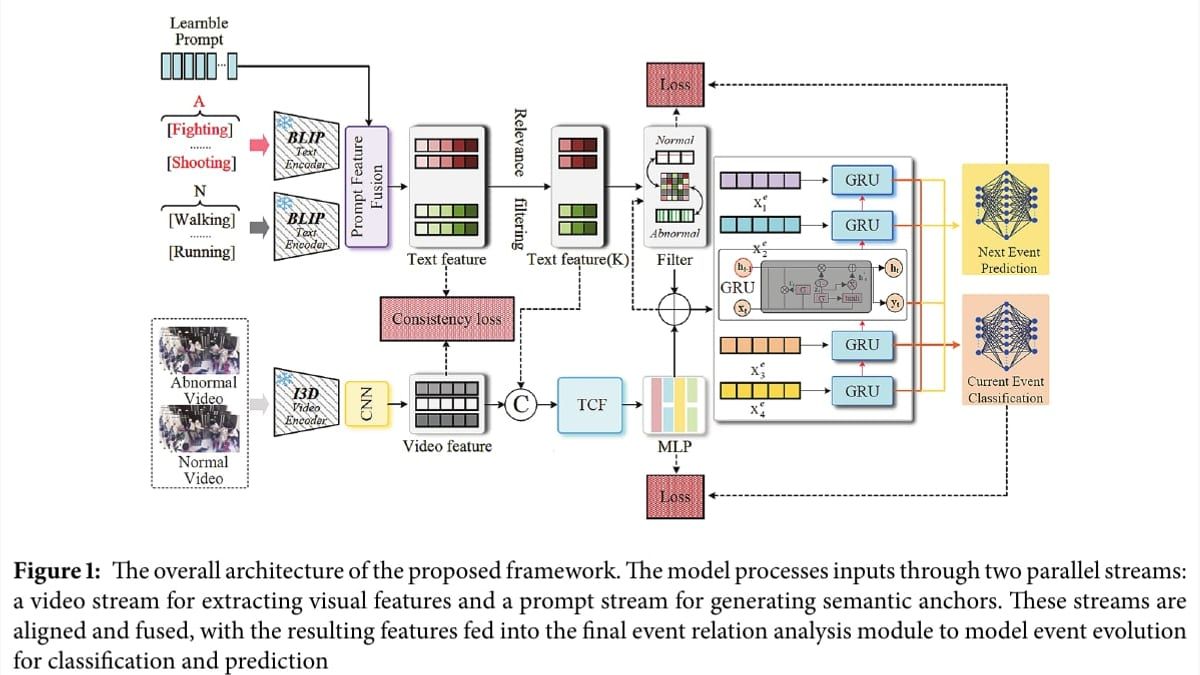
论文第4.2节用Kinetics预训练I3D,把互不重叠的16帧片段变成1024维特征。视频分支经时序上下文融合TCF和卷积预测器产生片段异常分数;文本分支把扩展概念编码成768维原型。高异常分数片段获得更高前景权重,低分片段形成背景表征;视觉表征与相应类别原型对齐,语义增强序列再进入GRU,输出当前和下一事件概率。
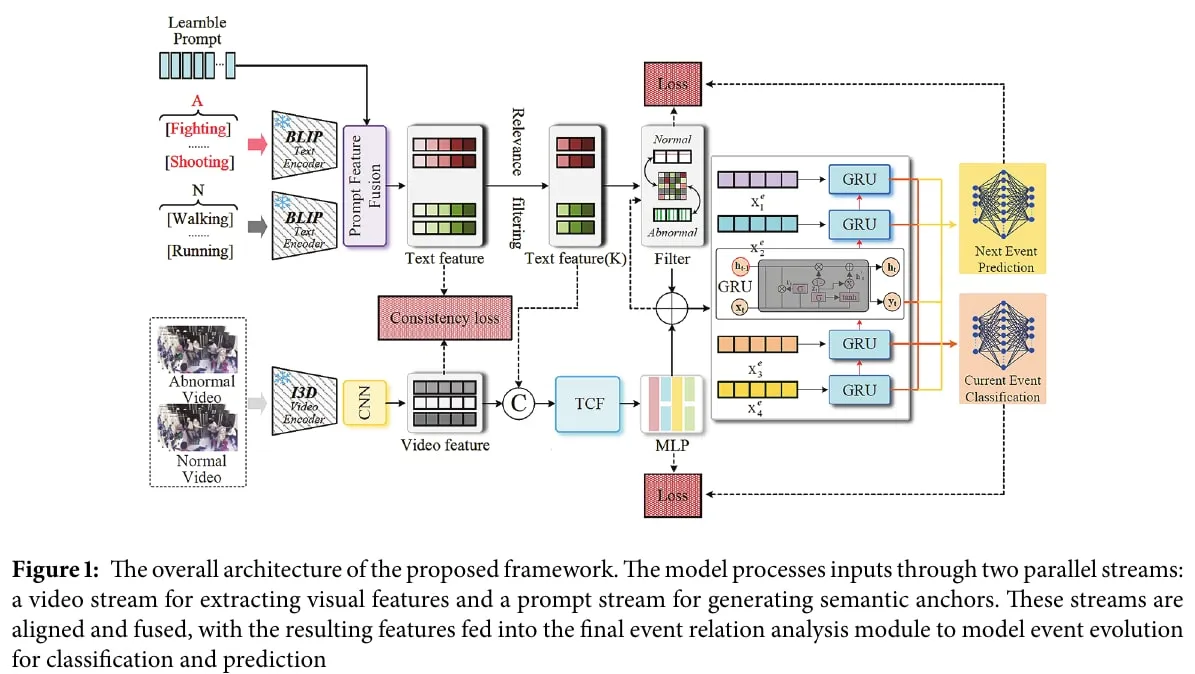
图注:来源:Gao等,Enhancing Anomaly Detection with Causal Reasoning and Semantic Guidance,Figure 1,CC BY 4.0;截图裁剪,保留原表头与说明。(Gao等,Figure 1,CC BY 4.0,第 5 页,来源:论文)
图1最应注意的是分类监督、语义对齐与事件预测之间的连接,而不是把三个模块当作独立串联黑盒。异常分数控制哪些片段参与语义摘要,这个摘要又反过来通过损失塑造检测特征,存在自增强反馈。如果初期异常分数被场景背景误导,外部知识并不会天然纠正选择错误。
论文称联合端到端优化,但明确以预训练I3D提取的特征作为输入。这里不能擅自改写成从原始像素到所有预训练骨干均联合更新;完整冻结/更新清单、特征缓存和文本编码是否在线计算,需要实现进一步确认。
设计一:位置先验与全局—局部融合
TCF先对片段特征做查询、键投影,用点积形成内容相似矩阵。式2再构造exp(-|κ(i-j)²+δ|)形式的位置关系,加入原始相似度;随后全局聚合和局部聚合由可学习门控混合,再通过残差与归一化得到增强特征。
这个设计的直觉是:内容相似与时间邻近各自有盲区。同一动作在视频远端出现,不必属于同一个异常事件;相邻片段又可能横跨事件边界。门控让模型在两者之间调节,比固定只看局部或只看全局更灵活。
不过论文从这种时序关系走向“因果”的论证不充分。位置差是对称的,式1—4没有展示遮挡未来片段的掩码。下游第3.3节虽然声明使用因果卷积,但如果输入已经汇集未来信息,后续单向算子无法撤销这些信息。因此本文只能确认作者设计了因果形式的预测头,不能确认完整系统满足逐时刻在线因果约束。
此外,式4里的NP2L以及局部聚合实现说明相对简略;没有代码时不能替作者补出某种确定运算。复现首先应核清矩阵形状、门控是标量还是逐通道、局部分支窗口,以及测试时究竟处理整视频还是滑窗。
设计二:知识扩展有价值,但引用次数不等于相关性
知识分支先从Wikidata的一组候选关系中,选择跨异常类别出现最频繁的三种关系,收集类别相关概念;删除deprecated条目,再以引用数量的均值作筛选阈值。BLIP把每个保留概念编码后平均,得到类别语义方向D_c。它不是逐条检索视频中的事实,而是把外部知识压缩为向量监督。
这样做可以把“纵火”从一个类别词扩展成更丰富的概念邻域,但筛选标准仍是一种启发式:知识库里被引用得多,只能间接支持可信度,不能保证与监控画面可观察内容相关。平均池化还会抹去关系方向与层级,所谓概念云并不等价于在检测器内保留完整知识图谱推理。
前景权重按exp(κs_t)-1归一化,背景权重用1-s_t构造。比普通softmax多减去1,使低分片段更接近零权重;κ增大则更偏向少数高分片段。视觉前景摘要与正确类别原型通过温度缩放的余弦匹配和KL式目标对齐。它提供的是类别语义约束,仍然没有获得真实帧级异常标签。
实现时还有两个应检查的细节:所有s_t极小时分母数值稳定性如何处理;视觉和文本维度不同,具体投影在哪里以及是否共享。原文的功能描述不能替代这些可执行细节。
设计三:事件关系学习的标签究竟来自哪里
ERA用GRU更新历史状态,再接两个输出头,分别识别当前事件和预测下一事件。关键不是GRU本身,而是损失目标。第4.2节明确说明,把异常视频的类别广播到每个片段作为初始事件标签。例如纵火视频的所有片段都先得到纵火类别,正常背景也被包含。作者认为MIL会帮助模型突出显著片段,但广播标签与逐片段真实事件不是一回事。
下一事件目标进一步由当前类别标签乘以知识转移矩阵产生,而非直接使用真实下一时间片发生的事件标注。于是模型学到某种“下一事件分布”,也可能只是学会复述先验矩阵。在没有独立未来事件真值、时间分割和预警指标的情况下,不能把这解释成已经证实的风险演化预测。
总体损失是异常检测、语义对齐、事件关系三项加权。作为辅助任务,它完全可能提升检测表示;但“辅助训练有益”和“因果机制已发现”是不同命题。作者在结论中把结构因果模型列为未来方向,也说明目前不能按严格结构因果识别来解读。
主结果:哪些比较支持竞争力,哪些不支持第一名
表1给出XD-Violence的86.49%帧级AP,表2给出UCF-Crime的88.19%帧级ROC-AUC。XD表中PE-MIL为88.05%,比本文高1.56个百分点,所以不能写成两个数据集全面最优。UCF表内UR-DMU为86.97%,差1.22个百分点;与MMVAD的87.78%差0.41个百分点。不同方法的外部知识、特征和监督仍可能不一致,这些是表内比较,不是受控重训证明。
原文把XD指标定义成PR曲线下面积并简称AP,本次没有代码可核其数值积分与average precision的实现差别,因此保持原名称并说明定义,不与其他实现机械混排。论文也未清晰区分全帧拼接和逐视频宏平均实现;复现应固定评价脚本。
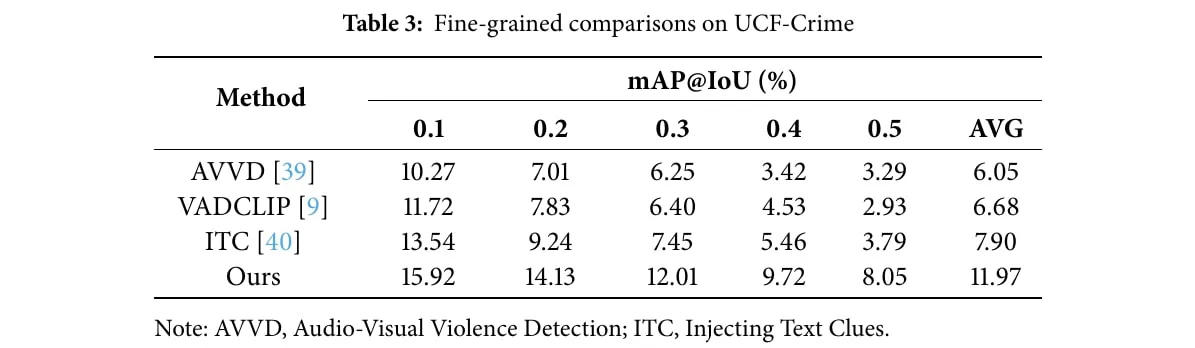
图注:来源:Gao等,Enhancing Anomaly Detection with Causal Reasoning and Semantic Guidance,Table 3,CC BY 4.0;截图裁剪,保留原表头与说明。(Gao等,Table 3,CC BY 4.0,第 14 页,来源:论文)
表3更接近作者强调的细粒度能力:UCF在IoU阈值0.1至0.5上的平均mAP为11.97%,表内VadCLIP为6.68%,ITC为7.90%。其中IoU=0.5时8.05%对2.93%,说明报告中严格边界匹配的改善较明显。但绝对mAP依然不高,不能把“相对提升大”写成实际定位已可靠;提案生成、阈值、类别映射和评价代码决定比较是否真同口径。
消融:更稳妥的结论是语义与辅助任务互补
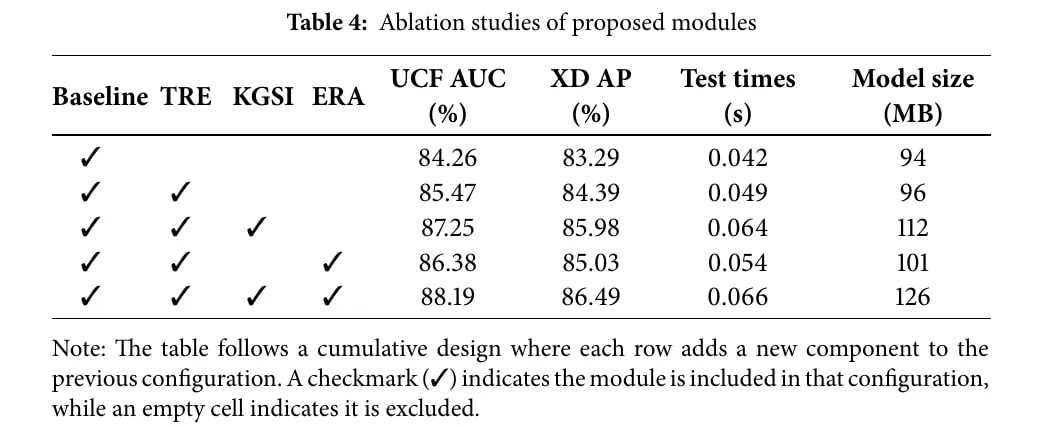
图注:来源:Gao等,Enhancing Anomaly Detection with Causal Reasoning and Semantic Guidance,Table 4,CC BY 4.0;截图裁剪,保留原表头与说明。(Gao等,Table 4,CC BY 4.0,第 15 页,来源:论文)
表4基线UCF AUC为84.26%,加入TRE为85.47%,再加KGSI为87.25%,完整模型为88.19%。相应增量是1.21、1.78、0.94个百分点。XD AP从83.29%到84.39%、85.98%、86.49%。这些数据支持三个组件在作者设置下均有贡献。
第四行是基线+TRE+ERA,不含KGSI,并非从第三行继续累加;表下注释称逐行累加与勾选本身不完全一致,阅读应以具体组合为准。比较第二行与第四行,ERA使UCF AUC增加0.91个百分点;比较第三行与第五行增加0.94个百分点,至少说明其收益不完全依赖知识分支。它仍不能区分GRU容量、额外分类监督和转移先验各自贡献,尚缺参数匹配和去掉转移知识的控制实验。
表5直接比较类别名称与Wikidata扩展原型:UCF从86.89%到88.19%,XD从85.26%到86.49%,分别增加1.30、1.23个百分点。这比一句“语义更丰富”更有说服力,但尚未显示随机同规模词表、错误知识和去引用筛选等对照,无法把全部收益归为知识关系本身。
表6中κ=10优于1、5、20;表7中GRU隐藏维256优于128和512。较大容量稍差不自动证明过拟合,论文没有相应训练/验证差距和多种子区间。对这类小幅差异,本文只称该次配置结果,不称统计显著或稳定最优。
效率、解释与预警:三种尚未闭合的证据
表4显示平均测试时间从0.042秒增加到0.066秒,模型文件从94MB增加到126MB。后者是存储大小,不等同参数个数或峰值显存;前者是单片段时间,不是首次报警延迟。原文据约15片段每秒讨论实时能力,但未清晰交代计时硬件、原视频解码、I3D提取、知识构建与全局序列等待是否计入。不能把该数字直接换成某台设备的端到端实时保证。
图6—7把事件转移权重画成热图和路径,能帮助检查模型关联了哪些类别,但热图不是因果证据。路径中出现“正常”节点可以有多种解释,不能据此认定现实中的人正在伪装。要证明预警,应给出严格只用历史输入的未来事件预测,以及不同提前量下的精度、召回和误报。
图8的异常曲线说明作者挑选的视频能产生合理峰值,没有给整体错误分布或困难失败案例。原文明确承认未用音频,并把多步预测和形式化因果模型作为后续方向;本次额外指出的信息泄漏风险、监督目标循环及实现细节缺口属于分析者判断,不是假称作者已经验证的缺陷。
最值得复现的版本
建议先实现不带“因果”宣称的检测版本:固定I3D特征、类别标签和评价脚本,比较类别词、扩展原型、随机原型;再把ERA拆成普通GRU分类、知识转移辅助、真实未来标签三个条件。随后将TCF全局分支改成严格过去掩码,并在完全独立验证集选超参数,最后报告未来事件预测而非只报当前异常AUC。
这篇工作提供了可检验的语义增强与多任务组合,但当前最可信结论是检测与定位指标改善。把它称为已建立可靠因果预警系统,会跨过证据边界。
来源与阅读范围
- 正式全文与PDF入口:已读全部方法、表1—7、图示、结论及资料说明,页面未提供独立补充实验材料。
- VadCLIP原文:核对冻结视觉语言骨干和双分支机制,作为语义对齐基线。
- PE-MIL原始论文:用于核对异常提示及正常上下文的关系,不将其图片搬入本文。