先给结论:联邦训练不是主角,验证接口才是
《Parser-Free VLM Verification for Federated Weakly Supervised Video Anomaly Detection》研究一个很具体的问题:轻量检测器先找出可疑片段,再请冻结视觉语言模型复核,究竟该读取模型生成的判断文字,还是直接读取下一词的 Yes/No 分数?本文精读的是2026年9月7日首次提交的 arXiv v1,不将它包装成当天新论文。
我的判断是:最有说服力的结果不是最高 AUC,而是不加时序平滑的 logit 接口,在两个 VLM 上都明显改善 AP。它避开关键词解析器,保留连续排序信息;但验证只覆盖 UCF-Crime,且联邦训练之后的 VLM 评估实际上集中、离线执行。因此,“轻量联邦检测”“片段级因果兼容”和“隐私保护的实时端到端系统”必须分开讲。(原文§III、§IV-E/F、§V)
它继承什么,又真正改了什么
Sultani 等的经典 MIL 方法把整段视频标签转成片段排序约束,并以稀疏和平滑约束限制异常时间范围。本文沿用视频袋、片段实例和弱监督思路,却并非原封不动复制那套最大值排名损失:这里采用冻结 CLIP 特征、top-3 平均池化与视频级二元交叉熵,再附加稀疏和平滑项。训练对象是小型 MLP,而不是 CLIP 或 VLM。
另一条比较线是生成式 VLM 验证。本文自身设置了密集零样本、选择性文本判断及选择性 logit 三类对照,因而核心问题不必借助跨论文排行榜回答。与“让大模型多解释一点”的路线相比,它把创新压缩为一个工程上重要的接口选择:同样的候选片段,输出如何成为可排序的数值证据。FedAvg、CLIP、MIL 和二词 softmax 都不是这里新发明的模块;贡献是把这些组件组合为可控级联,并系统诊断生成文本与概率接口的差异。(原文§II、§III-B/C)
从视频到分数:只有哪一部分在学习
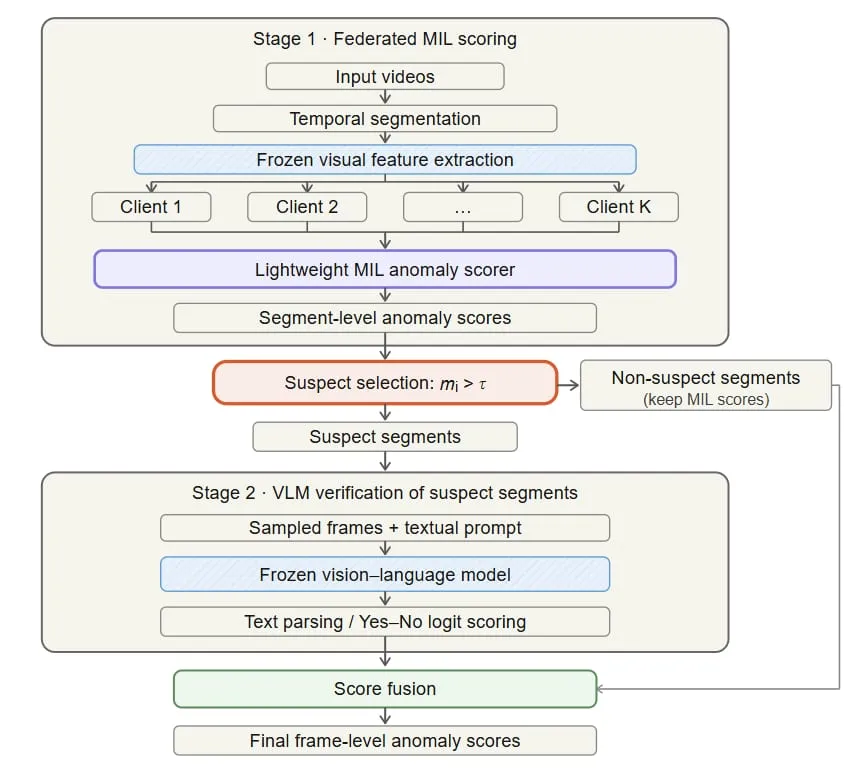
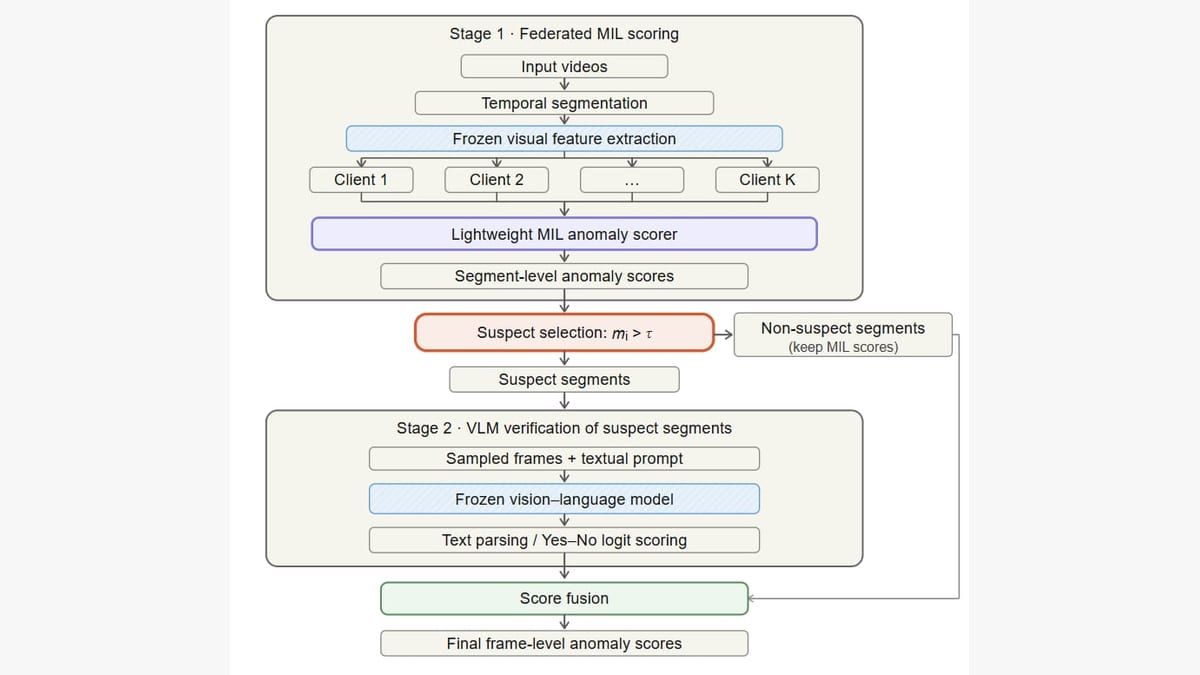
图注:图1:只对超过阈值的片段执行VLM复核;图示为模块流程,不是隐私或实时性能证据。 来源:Thuau等,arXiv:2609.07455v1,图1,CC BY 4.0(来源:论文)
图1要沿两条路径看:未进入复核的片段直接保留 MIL 分数;超过阈值的片段才进入冻结 VLM。图证明的是数据流和模块分工,不是隐私保证或吞吐测试。
每个视频均匀切成32段。第一阶段为每段预提取512维 CLIP ViT-B/16 特征,再输入宽度为512→128→32→1的 MLP;中间使用 ReLU、0.6 dropout,最后 sigmoid。可训练参数共69.8K。视频级预测取最高3段分数的均值,因此异常视频无需告诉模型具体哪段异常。
四台真实 CPU-only 客户端承担联邦训练。训练数据按视频级类别用 Dirichlet 分配,浓度0.5;FedAvg 训练30轮,每轮本地1个 epoch。CLIP 特征预先提取,VLM不参与参数聚合。这里的 CPU-only 描述限定于小头的训练,不能据此推导整套系统能在纯 CPU 上实时跑完。
第二阶段用固定阈值0.5筛选可疑片段,每段均匀取两帧,缩放到448×448,分别送入 InternVL3.5-2B 或 Qwen3-VL-2B-Instruct。复核之后把片段得分扩展到对应帧。这样的评估仍是帧级排名,而不是像素定位、事件识别准确率或报警延迟。(原文§III-B、§IV-A)
设计一:选择性复核省了调用,也封住了纠错范围
候选集合是 MIL 分数大于0.5的片段。平均每视频复核8.09±0.41段,占32段的25.3%±1.3%;相对密集复核,VLM调用次数减少约3.95倍。五个检测器检查点平均有51.7%的测试视频完全不调用VLM。
这解释了级联为什么可能比直接全视频问答更实际:不把昂贵模型用在明显正常的位置。但从设计可以推导一个不可回避的代价:低分漏检不会被复核器发现。无论 VLM 多强,候选集合之外都保持原分数。这不是作者已经测出的漏检比例,而是路由规则的逻辑后果。更完整的下一步实验应同时画出阈值、异常片段召回率、调用比例和最终 AP;仅报告调用减少,不能证明最优成本收益点。
同样,调用减少3.95倍不等于端到端加速3.95倍。CLIP编码、帧解码、输入打包、通信和 VLM 单次推理仍有开销;论文没有提供覆盖这些环节的部署延迟证据。它确立了可计算的预算节省,而不是完整实时系统证明。(原文§IV-A;后两段为本文分析)
设计二:从文字修正转为连续排名
文本方案用关键词判断是否异常,正常则把原分数乘0.1,异常或解析失败则维持原分数。这个规则容易实现,却会把“并不异常”这样的否定句交给一个不理解否定的解析器;长推理同时提到正常和异常线索时也可能误判。原文明确承认这一点。
logit方案不要求自由生成解释,而固定询问场景是否正常,读取 Yes 与 No 两个候选的下一词logit。因为问的是“正常吗”,No对应异常。对两个logit作受限softmax:
$$p_i^{\mathrm{VLM}}=\frac{\exp(\ell_{\mathrm{no},i})}{\exp(\ell_{\mathrm{yes},i})+\exp(\ell_{\mathrm{no},i})}.$$
复核片段的输出为 $s_i=\lambda p_i^{\mathrm{VLM}}+(1-\lambda)m_i$;主设置取 $\lambda=1$,直接替换可疑片段原分数,不进行时序平滑。未入选片段仍用 $m_i$。这比“按文字分成正常或异常,再统一衰减”保留了更多候选间的细粒度次序。
但受限softmax不是校准好的真实异常概率。它只比较两个预设token;作者核实了各自 tokenizer 和推理模板下的单token延续。换模型、模板或语言时必须重新核验,不能把任意“Yes”字符串的token ID直接照搬。主设置把两种模型产生的分数拼在同一时间线上,也留下一个分析问题:MIL低分与VLM替换分数是否可比?改善排名的结果是经验支持,不构成跨模型统一校准的证明。(原文§III-C/D、§IV-E)
证据一:提示词多,不代表原始信号更强
论文先在一个较好检查点上探索14种文本提示策略。这是诊断性探索,不是独立验证集上的模型选择流程。表II中仅5种策略的原始 F-AUC 变化为正;最好的是数值打分提示,提升0.254个百分点,而多轮推理下降1.046个百分点。数字不能证明“推理普遍无用”,只能说明该提示与关键词修正规则的组合不稳。
尤其值得注意的是输出分数塌缩:InternVL主要使用3、5、7,并没有充分利用0—10刻度;Qwen3在对应实验中收缩到5与7,作者需做模型特定映射。换成数字输出并不自动产生连续、可比的置信度。
表III继续加入时序后处理。InternVL的R11从原始+0.120±0.030变为+1.553±0.211;R12甚至从负收益变为正收益。因此,不能把最终 AUC 全部记在语义推理名下。作者把这些依据 F-AUC 挑出的后处理结果明确视为诊断上界,而不是可直接部署的参数选择协议。(原文§IV-C/D,所有变化单位为百分点)
证据二:真正拉开的是 AP,而非所有指标通吃
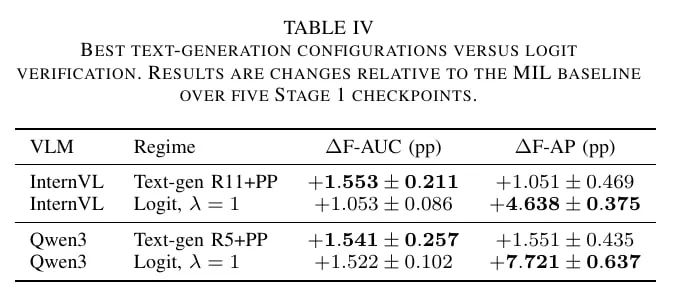
图注:表IV:两个VLM的AUC/AP增量,单位百分点;五个Stage-1检查点。正文说明UCF-Crime数据集与诊断性后处理选择。(Thuau等,arXiv:2609.07455v1,表IV,第5页,CC BY 4.0,第 5 页,来源:论文)
表IV应横向比较同一VLM的两种接口,并区分AUC与AP两列。InternVL的最佳文本后处理带来+1.553±0.211 F-AUC与+1.051±0.469 F-AP;无平滑logit对应+1.053±0.086与+4.638±0.375。Qwen3文本后处理为+1.541±0.257与+1.551±0.435,logit为+1.522±0.102与+7.721±0.637。
所以正确结论不是“logit处处更高”:InternVL的AUC收益反而低一些。更强的观察是,logit在两模型上保留较好的AUC改善,同时显著增加AP收益。AP更直接暴露高分候选里的假阳性问题;但这仍是整套测试帧排序评价,不能换算为某个业务报警阈值下的准确率。
这些结果跨五个选定检查点汇总。原文说检查点原始AUC在83.78%—84.00%,平均83.86±0.08;它们不是表I全部75次联邦运行的无条件随机样本。比较同一检查点前后的增量有助于控制基线差异,但“选了较好的检查点”仍限制对任意训练种子表现的外推。表中的±也不能擅自称作置信区间。
以平均基线换算,作者给出的logit绝对AUC约为84.91%和85.38%。这不是跨协议SOTA证明:联邦客户端划分、特征、训练机制与FedVAD、FedWSAD不同。全文主要支持“同一轻量MIL检测器能从更合适的验证接口获益”,而不是“已打败所有联邦异常检测器”。(原文§IV-B/E)
还有一个需要读表而非看摘要的地方:密集零样本并不是强基线的同义词。表I中,InternVL简单问题的帧级AUC为74.7%,Qwen3为55.1%;换成VERA式提示后分别为65.3%和49.2%。这一结果说明被冻结模型的常识能力并不会自动变成该监控域的可靠异常刻度,也使“先用训练过的轻量头筛选”具有实际动机。然而,密集基线与级联不仅查询次数不同,评分接口和条件分布也不同,不能只据这张表把所有差距归于路由。复现时必须把提示文本、采样帧、token分数与融合方式逐项对齐,才能隔离因果来源。
设计三:片段因果,离真正在线还差什么
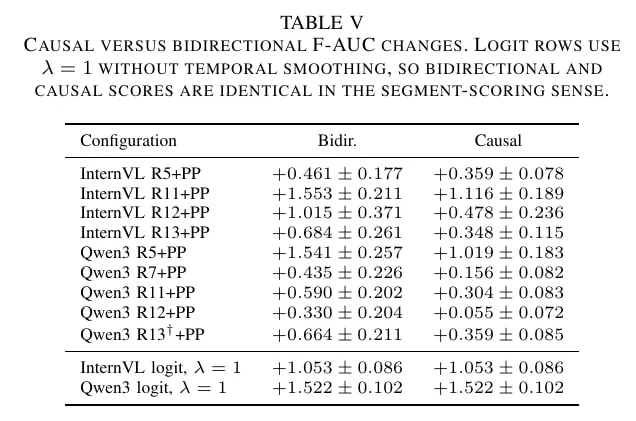
图注:表V:UCF-Crime帧级AUC增量(百分点);无平滑logit两列相同来自片段独立计算,不等于端到端在线性。(Thuau等,arXiv:2609.07455v1,表V,第6页,CC BY 4.0,第 6 页,来源:论文)
表V比较双向与因果后处理。Qwen3 R5文本后处理的AUC增量从+1.541变为+1.019;InternVL R11从+1.553变为+1.116。logit主设置两列相同,是因为每段独立替换且不平滑:这是一项结构性质,不是额外获得了一份更强实验结果。
作者对“因果”的限定非常重要:片段及所采样帧已经可用后,当前评分不依赖未来片段。但整个视频仍预先等分32段,真实流的总时长通常未知;两帧采样本身也要求片段已到齐。因而当前证据不能支撑逐帧零等待在线报警。去掉双向平滑只是清除了一种未来信息依赖,尚未解决自适应分段、未知终点或实际延迟。(原文§IV-F)
边界与值得复现的三个问题
作者承认:仅一个数据集、四个按Dirichlet划分的客户端、预提取特征、固定路由与融合参数,以及集中离线VLM评估。联邦训练不集中原视频,不意味着集中验证同样不传视频;若把帧送往服务器,隐私仍取决于部署。
本文进一步建议三项受控实验。第一,固定VLM预算比较阈值路由与随机路由,分清“挑得好”与“少问了”的效果。第二,在独立验证集上固定所有提示和后处理,再测试logit优势,避免诊断上界被误当泛化结果。第三,改用固定秒数因果窗口,记录解码、CLIP、VLM和通信的端到端延迟,同时报告候选外漏检。三者分别回答路由、选择偏差和在线性,均比再加一层复杂模块更能检验本文主张。
这篇论文的可迁移启发是:**让大模型进入检测链条之前,先把它的输出定义成可核验的接口。**解释文本可以帮助人理解,但它不必承担稳定排序信号的全部责任;反过来,概率接口更好排序,也不代表解释、校准和隐私问题已经解决。
来源与许可
主文:arXiv:2609.07455v1,完整正文,首次提交2026年9月7日,CC BY 4.0。本文按§III—V核对方法、表I—V与作者局限;当前版本未附独立补充材料。图1及表IV、V取自主文并保留署名出处,裁剪仅用于展示对应图表。
背景核对:Sultani等,Real-world Anomaly Detection in Surveillance Videos,用于区分经典MIL排名损失与本文top-k交叉熵训练,不引用其图像或整段原文。本文未运行作者代码,讨论的是公开实验报告与可由计算规则推出的边界,不是独立复现实验。