先说判断:双记忆提高了排序,但没有包揽最低误报
UR-DMU解决的是视频级标签下的异常时间定位:训练时知道整段视频是否含异常,却不知道哪一小段真异常。它最值得学的不是“再加一个记忆库”,而是把正常视频中的可靠正常片段、异常视频中的正常背景、真正异常片段分别组织起来,再用正常分布的扰动训练拉开边界。主结果和模块消融支持这种组合有效,却不能推出双记忆在所有阈值下都更少误报;论文自己的表3恰好提供了反例。
本文精读Hang Zhou、Junqing Yu、Wei Yang的AAAI 2023论文,使用2023年2月10日提交的arXiv v1全文,不是新发表论文。该版本登记为CC0。同时核对官方代码的记忆读取、推理和评价实现;以下数字是作者报告,不是本站复现实验。
从RTFM到双记忆:究竟换了什么
RTFM用学习后的特征幅值选择异常候选,并通过幅值间隔及分类损失拉开正常、异常视频。这给UR-DMU留下两项遗产:弱监督MIL框架,以及“正常和异常可以在学习后的幅值空间分离”的假设。UR-DMU并没有废弃幅值,而是把它放进记忆增强后的潜在空间;区别是候选不再仅由一个长度大小决定,还由对正常、异常原型的匹配决定。
另一条来源是正常性记忆网络。只存正常模板适合正常数据训练,但弱监督任务本来拥有异常视频标签,完全不用它学习异常模板会浪费信息。因此UR-DMU增加异常记忆,试图区分表面动作相似、上下文意义不同的片段。它不是把每类犯罪硬编码为一个槽,也不保证记忆槽对应可解释语义。
创新应看成三部分的配合:全局与局部时序特征、两套带监督约束的可学习记忆、只对正常输入使用的随机潜变量。注意力、三元组、重参数化都不是新运算;值得验证的是这些设计是否解决同一个弱监督污染问题,而不是逐个模块名字是否新。
数据流:从16帧片段到逐帧分数
论文第3.1节以连续16帧提取I3D特征,I3D来自Kinetics预训练。后续训练使用预提取特征,不应描述成整套像素骨干端到端重训。训练把每个视频组织成200个片段,批次中正常和异常视频数量相同。时序模块输出每个片段的表示,再同时查询正常、异常记忆;两路增强表示进入潜在编码,与原时序表示拼接后送入分类器。
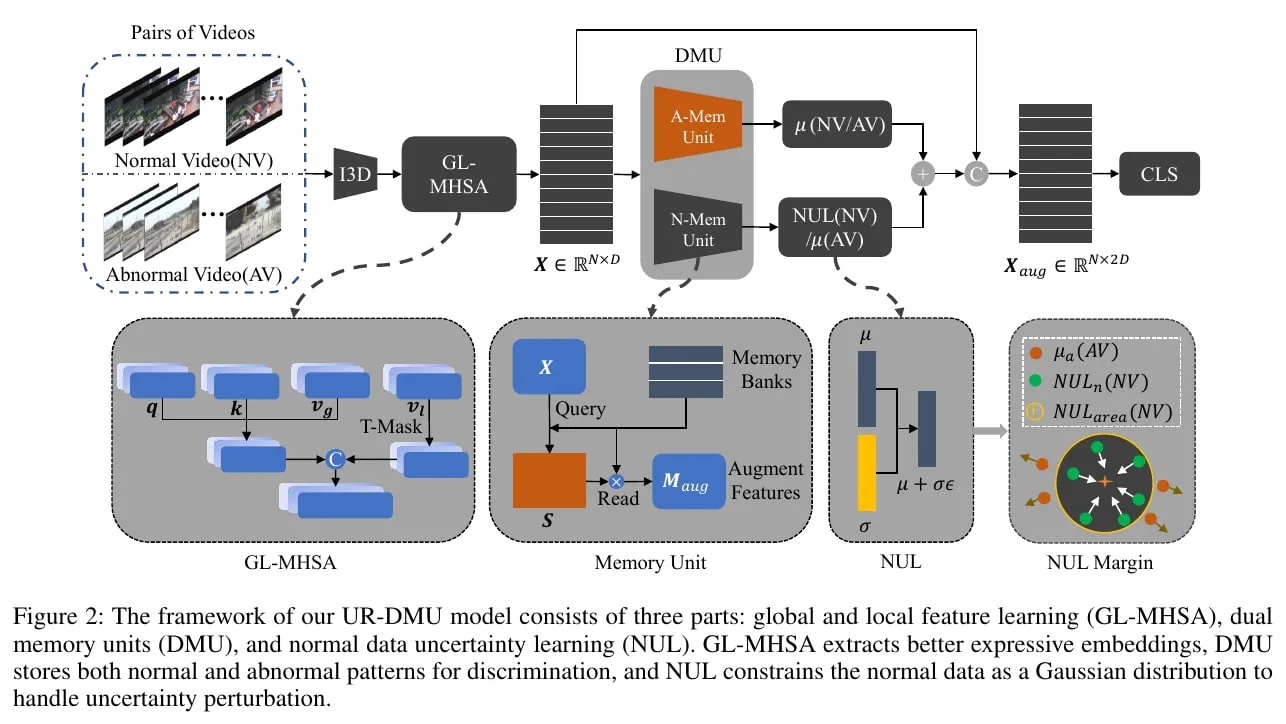
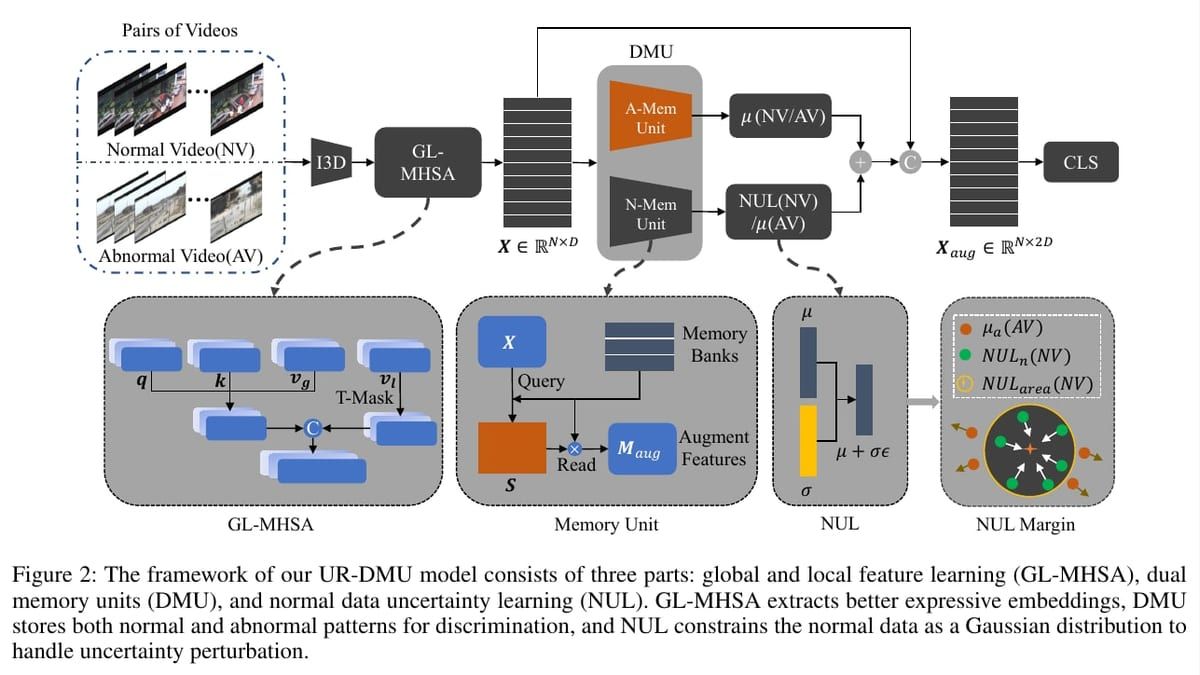
图注:UR-DMU原文图2:时序建模、双记忆与正常不确定性训练的数据流。来源Hang Zhou等,arXiv:2302.05160v1,CC0;裁出图及原图注。(Figure 2,第 3 页,来源:论文)
读图2要沿实线先追踪主干,再看下面三个放大模块。原特征不是被记忆完全替换,而是保留后再拼接,因此消融收益也可能来自增加表示容量。图中的随机正常特征属于训练路径:测试只使用均值编码,不采样方差。官方model.py先投影到512维,最终分类头输入1024维;这解释了图中从D到2D的变化。
推理中两个记忆都查询同一个测试序列,没有先知道其视频标签再决定分支。两路均值编码相加,与时序表示连接,输出片段概率。官方测试脚本先平均多裁剪预测,再把每个片段分数重复16次映射到帧。这是时间定位分数,不是像素或对象框定位。
设计一:两种时序关系不是两种因果关系
全局分支按内容相似度计算注意力,局部分支则用时间间隔构造权重。式1令距离越远权重越低,式2把两种聚合结果拼接并映射。前者可把远处相似动作联系起来,后者保留附近片段连续性;两者组合避免只靠内容相似把不相邻场景混在一起,也避免局部窗口看不到完整事件。
但“局部”不等于“在线”。距离使用绝对值,前后片段都能贡献;全局分支更没有因果掩码。官方translayer.py也对完整序列计算注意力。于是本文的判断是:它是离线序列模型,不能直接从低计算量推导低延迟实时报警。若部署为滑窗或单向模型,必须重新测准确率和事件发现延迟。
设计二:两次top-k在不同维度上工作
记忆矩阵M有若干可学习槽,每个槽是D维向量。式3先计算S=sigmoid(XMᵀ/√D),得到“片段×记忆槽”的相似度,再用SM生成增强特征。这里不是softmax,因此各槽权重不必加总为1;增强表示的幅值会受槽数、多个槽同时激活等因素影响。
式4首先在记忆槽维取top-k并平均,得到每个片段对某一类记忆的匹配程度。接着训练约束又在时间维选高匹配片段。原文把槽与片段混称容易误读,官方memory.py明确前者按槽数除以16再加1,model.py明确后者按时间长度除以16再加1;不能用同一个固定k替代两个操作。
正常视频的所有片段都应匹配正常记忆、不匹配异常记忆。异常视频却不能全标异常,因此只要求其中有高匹配的异常候选,同时从中寻找正常背景。三元组把正常视频候选作为锚,异常视频里的正常候选作为正例,异常候选作为负例。真正有针对性的一点是:它不只把两个视频拉开,还试图把跨视频的正常内容拉近。
风险也在这里。异常视频内的“正常候选”仍由模型自身挑选,若记忆初期记住背景而非事件,正负角色可能错置。本文没有把这推断写成已发生的失败;它是需要针对跨场景测试和候选可视化检验的机制风险。
设计三:不确定性是训练正则,不是报警置信区间
式7—9为正常记忆增强特征预测均值和方差,用z=μ+σε采样,并以KL项约束其接近标准高斯。直观上,正常动作不应因为镜头切换、主体变化等小扰动立刻越过异常边界。随机训练让分类器接触正常表示周围的一片区域,而非只记住一个点。
异常表示则进入同一均值编码空间,式10以间隔损失推动异常幅值超过正常表示。这里有重要复现差异:论文写平方L2范数,当前官方model.py的distance使用未平方的L2范数。两者会改变尺度与梯度,不能称代码与公式完全一致。论文式11是分类损失加四个辅助项,正文“five auxiliary losses”的文字也不应照抄。
测试省略方差分支意味着最终输出不是贝叶斯后验不确定性,也没有给报警附上校准置信区间。更准确的称呼是:正常潜在分布驱动的训练正则。标准高斯是人为约束,不是已证明所有正常视频天然服从单峰高斯。
主结果:同模态比较有提升,音频不是主要增益
UCF-Crime训练集含视频级标签,测试用逐帧标签;论文采用10-crop I3D RGB特征。表1报告86.97% ROC-AUC,对比表内RTFM的84.30%,相差2.67个百分点;与MSL的I3D结果85.30%相比差1.67个百分点。MSL另一行85.62%使用VideoSwin,虽然差1.35个百分点,但这不是同骨干的纯方法消融。
XD-Violence使用5-crop RGB特征,表2的81.66%对比RTFM的77.81%,相差3.85个百分点。加入VGGish音频后为81.77%,仅增加0.11个百分点。这支持RGB版本本身已贡献主要结果,不支持“音频融合带来巨大跃升”。跨论文数据增强、特征文件和训练选择不同,表格排名仍不能替代统一实现下的公平对照。
指标尤其要注明:作者把XD指标写作AP,定义为PR曲线面积。官方xd_test.py实际调用precision_recall_curve再做auc(recall,precision),并非average_precision_score。本文保留论文名称“AP”,但它在这份实现中是梯形积分PR-AUC。UCF和XD脚本均串接所有视频的帧预测再评价,不是先对每个视频计算后取宏平均。
消融揭示:双记忆的收益和误报代价可以同时存在
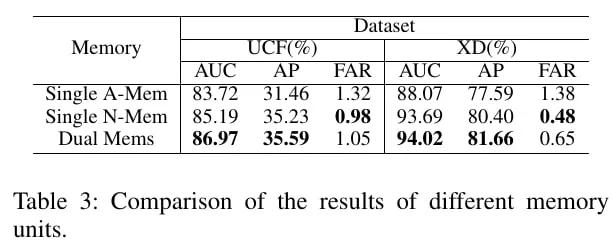
图注:原文表3:单正常记忆的FAR低于双记忆,但排序指标较低。保留全部表头及原表注;来源Hang Zhou等,arXiv:2302.05160v1,CC0。(Table 3,第 6 页,来源:论文)
表3最有解释力的对照是单正常记忆与双记忆。UCF ROC-AUC从85.19%变为86.97%,XD的AP从80.40%变为81.66%;然而正常视频FAR分别从0.98%升到1.05%、从0.48%升到0.65%。因此“双记忆全面降低误报”是比证据更强的结论。排序指标综合许多阈值,而FAR对应特定操作点,两者并不必然同向。
只存异常记忆表现更弱,UCF AUC为83.72%,XD AP为77.59%。这与正常数据更可靠、异常视频标签内部含大量背景的解释一致,但不能仅凭这张表证明是哪类场景污染导致差距。进一步记录每个槽读取的高响应片段,才能检查模型到底学了事件还是背景。
表4的槽数扫描也不单调。两类各60槽取得作者选择的主指标最佳配置,但更大记忆并非更好,最低FAR也不在同一行。不能把60当成跨数据集普适常数;部署到新摄像头,容量、重复原型和选择偏差都需要验证。
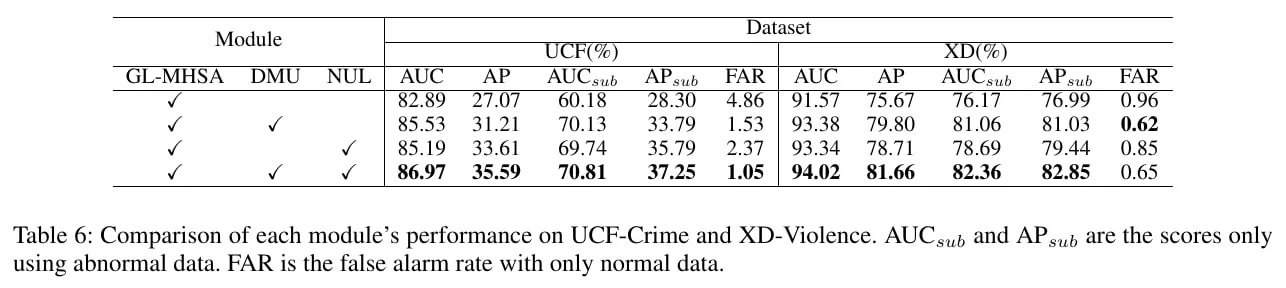
图注:原文表6:模块消融。注意完整模型并非所有FAR均最低;来源Hang Zhou等,arXiv:2302.05160v1,CC0,保留指标及脚注。(Table 6,第 7 页,来源:论文)
表6把模块贡献拆得更清楚。单独时序骨干的UCF AUC为82.89%,加DMU到85.53%,完整模型到86.97%;XD AP依次75.67%、79.80%、81.66%。NUL在双记忆之上仍有增益,支持它不只是重复记忆功能。不过XD FAR从DMU版本0.62%变为完整版本0.65%,再次提醒读者不要把“所有主要排序指标提高”偷换成“所有指标提高”。
损失消融中,表5去掉距离项保留其余三项时,UCF AUC为86.60%、XD AP为80.79%,完整版本再提高0.37和0.87个百分点。这个结果与“距离项提供补充作用”相容,但论文没有在这些表里提供多次随机种子的方差,不能把小差距写成统计显著或训练稳定性保证。
定性证据与真正的边界
图4展示八个视频,部分正常段的峰值确实比RTFM低,部分异常窗口更接近标注。它是定位行为的例子而非全数据集错误率估计;尤其模型还会出现边界粗糙和漏检。作者在结论中明确承认,片段级特征使预测窗口和分数仍粗糙、不稳定,并计划进一步细化时间和空间定位。
另有三项本文提出的边界。第一,既然使用全局双向关系,就不能宣称在线因果检测。第二,基于预提取I3D特征的训练便利不等于从原视频输入的低成本;多裁剪、特征提取、存储和注意力都应纳入部署预算,正文没有完整端到端延迟证据。第三,正常分布与记忆槽是在当前数据分布下学习,新场景、正常动作变化或未见异常是否仍分离,不能由两个标准测试集自动保证。
官方测试代码没有逐视频min-max步骤,但本次未逐项审计所有特征生成和数据加载分支,所以只对已读测试路径作这一限定判断;不据此担保整个上游没有信息泄漏。
对后续研究最有价值的三个实验
首先固定相同I3D特征和数据划分,将单正常记忆、双记忆在相同FAR下比较召回,而不只比较各自AUC。其次把全局注意力改成因果或有限前瞻,在准确率之外报告首次报警延迟,检验离线收益有多少来自未来信息。最后分别复现平方与非平方幅值间隔,并记录槽激活、种子方差和跨场景结果;这比继续堆一个模块更能说明机制是否可靠。
复现时应锁定论文v1与代码提交,区分槽维/时间维top-k、10-crop/5-crop、PR积分/AP以及训练采样/测试均值。UR-DMU最有用的启发是“正常性也需要被主动组织”,而不是记忆越多越好,或加上不确定性就自动得到可信报警。
来源与复核范围
- UR-DMU arXiv v1全文:已读正文、公式、主结果、消融、定性与结论;该PDF未附独立补充实验章节。
- UR-DMU官方实现:核对memory.py、model.py、translayer.py、ucf_test.py、xd_test.py;未运行训练。
- RTFM原文:核对幅值候选选择与分类损失,作为最近机制基线,不将其非独占分发许可当作图片复用授权。