核心问题:为什么看得更久,反而检测得更差?
正常行人可以转身、停步、改变步幅。把这些姿态连续起来,模型本应更容易区分行为;但如果训练时给每个关节坐标独立加噪,时间窗口越长,越容易制造人体根本不会做出的轨迹。STEP的切入点不是“再增加一层时序网络”,而是先问:密度学习所依赖的扰动空间,是否与人体运动的结构相容?
本文精读2026年8月20日提交的《STEP: Score-Based Temporal Energy for Human Pose Video Anomaly Detection》v1,包含完整补充实验。它使用正常训练姿态,不是视频级异常标签监督,也不是音视频多模态方法。最有力的贡献证据是时间窗口与表示空间的交叉消融;最需要保留的边界则是姿态提取失效、场景迁移,以及“在线”得分与平滑后高分之间的距离。
从MULDE出发:学能量,而不是生成下一段视频
必要前作MULDE用去噪分数匹配学习多噪声尺度的负对数密度近似。其原论文§3.3—3.4通过尺度对齐正则缓解能量常数不一致,并用正常样本拟合的高斯混合模型汇总多尺度响应。推理时只需要能量网络前向计算,而不需要执行完整反向扩散生成。
STEP继承“用能量刻画正常分布”的思路,却不直接把长姿态坐标串塞进原模型。它先拟合正常运动的主成分空间,再在白化坐标中加噪,配合姿态置信度与噪声条件网络。最终也不沿用MULDE的GMM汇总,而采用各尺度标准化能量的最大值。这里的创新应归于人体时序表示与训练、评分的配合,不应描述成首次提出多尺度去噪密度估计。(主文§2—3)
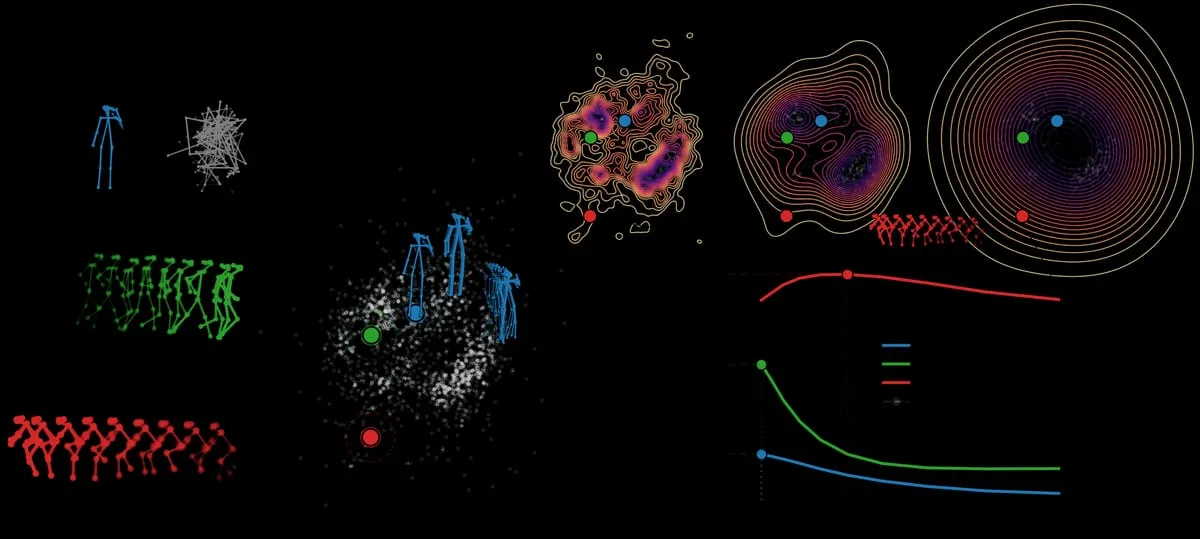
图注:图1:在正常姿态主成分空间学习能量,推理使用标准化多尺度响应;原图,未修改。 来源:Micorek等,arXiv:2608.19987v1,图1,CC BY 4.0(来源:论文)
设计一:PCA白化决定了模型学什么扰动
输入是同一人的关节序列,包含二维坐标、多个关节和连续时间帧。论文使用AlphaPose的18关节输出,默认窗口长度T=12、保留主成分K=48。先用正常训练样本估计均值、特征向量与特征值,再进行投影和白化:
$$z=\Lambda_K^{-1/2}W_K^\top(x-\mu).$$
投影减少冗余维度;白化则让各保留方向拥有可比较的尺度。否则同样大小的高斯扰动可能淹没小方差方向,却几乎不改变大方差方向,模型学到的噪声恢复任务便与真正的行为偏离不成比例。
这不是一句“降维有用”就能概括的处理。原坐标中的独立噪声不关心手臂、躯干和连续帧的协同变化;主成分将正常训练中共同变化的方向集中起来,使扰动更接近已有运动结构。论文的主成分遍历可视化支持这种解释,但PCA仍是线性近似,没有显式保证骨长、关节角或动力学约束。因此“运动更合理”是经验性描述,不等于每个采样点都满足人体物理规律。
PCA还有一个容易漏掉的边界:被截断方向可能同时包含噪声与细微异常。K太小未必只删掉无用信息,K太大又会重新引入高维扰动困难。T与K必须一起看,而不是把48当成跨数据集通用的最佳维度。(主文§3.1及表2)
设计二:置信度、噪声条件与能量评分
模型在投影姿态周围加入不同强度高斯噪声,通过能量对输入的梯度去匹配解析去噪目标。训练损失乘以平均姿态置信度,并使用噪声平方权重平衡尺度。论文使用10个几何间隔噪声水平,范围0.1到1.0。网络由四个宽度1024的隐藏残差块组成,噪声条件不只在输入端拼接,还调制每个块。
需要区分训练和推理:训练计算能量梯度以施加分数匹配约束,推理则直接读取标量能量,不把梯度范数当异常值,也不用反复去噪生成骨架。每个尺度的能量以正常训练统计量标准化,再取最大值并乘以当前姿态置信度:
$$A(x)=c(x)\max_i\frac{f(\pi(x),\sigma_i)-\mu_i}{s_i}.$$
这个最大值类似连续的“或”:只要某个尺度认为该轨迹偏离正常,信号就不会被其他低分平均稀释。补充表S6在K=48时,求和为87.2 AUROC,最大值为90.4,事后最优单尺度为90.3。这支持该汇总在本配置有效,却不把输出变成校准过的异常概率;某一噪声尺度也可能放大偶发错误。
置信度加权同样有两面。它让跟踪质量差的姿态不至于主导训练与报警,但真实跌倒、遮挡或拥挤恰好可能降低姿态置信度。低置信并不等于正常,给低置信异常降权可能造成漏检。论文补充失败案例中的姿态丢失,正是读者不能忽略的上游依赖。(主文§3;补充§C.6、失败案例)
实验口径:主榜单、单次消融与测试后处理分开读
主结果使用帧级micro-AUROC,把测试帧汇集评价;没有逐视频归一化,但使用一维高斯时间平滑。论文报告20次独立运行的均值与标准差,而消融表使用固定随机种子。这解释了主表UBnormal为90.1±0.4、消融基准却是90.4,不能混写成同一个统计结果。
训练使用AdamW、批量1024、最多400轮和EMA权重。T、K的默认配置由UBnormal验证集选择;该数据集按验证AUC早停,ShanghaiTech固定训练400轮。正常样本训练不意味着整个开发过程完全不接触异常验证标签,监督口径应区分训练目标和模型选择。
主表1中,STEP在ShanghaiTech完整测试集为86.2±0.1,人体相关子集为87.7±0.1;UBnormal对应90.1±0.4与90.9±0.4。对照SeeKer在UBnormal完整集77.9,差为12.2个百分点;与STG-NF在ShanghaiTech完整集85.9相比,只高0.3个百分点。不能把前一个大差值推广到所有数据集,也不能把百分点改写成相对百分比。
另一个边界来自补充表S1:其中对象中心MULDE在ShanghaiTech为86.7,高于STEP的86.2。因此本文不沿用“胜过所有多模态方法”的笼统叙述;姿态方法、对象特征方法的输入信息和预处理也不相同。真正可靠的结论是STEP显著改善了特定姿态密度路线,而不是全信息条件下无条件最优。
最关键消融:时间与表示之间的相互作用
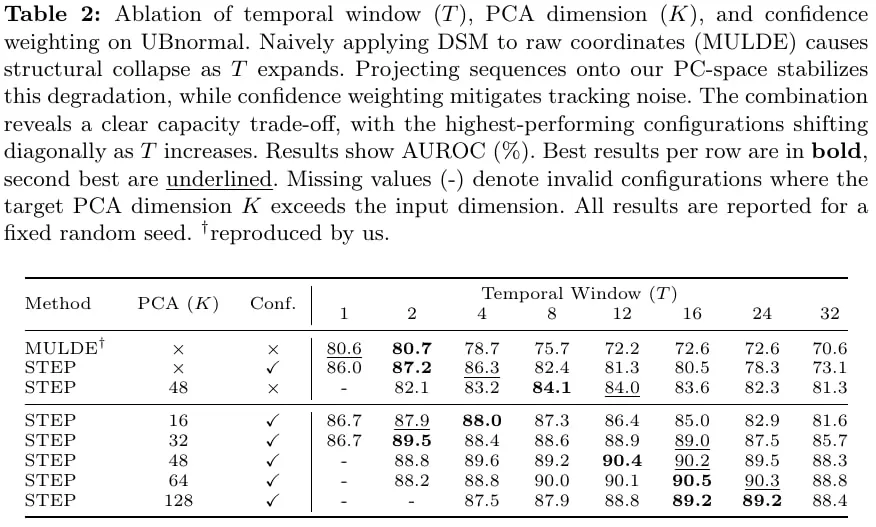
图注:表2:长窗口退化与PCA、置信度的交互;固定随机种子AUROC,勿与20次运行均值混用。(按原页裁切。)(Micorek等,arXiv:2608.19987v1,表2,物理第13页,CC BY 4.0,第 13 页,来源:论文)
表2中,直接在坐标上应用MULDE,从T=1的80.6降到T=12的72.2,再到T=32的70.6。只加置信度虽然缓解问题,T=12达到81.3,但长窗口仍恶化。加入K=48的PCA而不加置信度,T=12为84.0;两者结合则达到90.4,T=32仍有88.3。
这一组数字比单个榜单第一更能说明方法为什么有效:长窗口不是天然有害,问题在于怎样表示和扰动它;置信度也不能替代结构表示。反过来,PCA独自存在仍没有取得完整收益,不能把提升全部归功于一个预处理步骤。
表3进一步核对实现细节。默认固定种子配置ShanghaiTech/UBnormal为86.3/90.4;改普通MLP降至85.6/89.3,去掉白化降至85.5/88.2。把置信度低于0.4的姿态直接丢弃,降至84.3/85.9,说明软加权与硬删除并不等价。异常与快速正常运动都可能产生不稳定姿态,简单删除会改变正常分布覆盖。
这些消融没有给每项20次运行的区间,小差值应谨慎解释。表2也存在K=64、T=16达到90.5的测试成绩,不能据此指控默认48/12选择错误:论文声称按验证集定配置,测试最大值不是合法调参依据。(主文表2—3)
“在线”与实时部署,必须拆开看
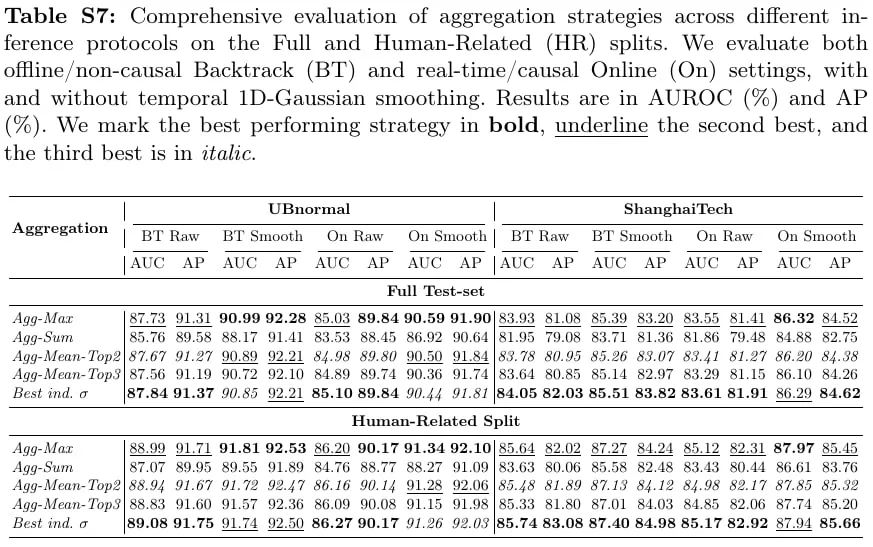
图注:表S7:保留Full/HR、BT/On及Raw/Smooth全部列。Online列不能取代延迟、滤波因果性的单独核验。(按原页裁切。)(Micorek等,arXiv:2608.19987v1,表S7,物理第31页,CC BY 4.0,第 31 页,来源:论文)
补充表S7分开报告回填式Backtrack与Online,并列出不平滑和高斯平滑结果。UBnormal完整集Agg-Max的Online原始AUROC为85.03,平滑后90.59;ShanghaiTech分别83.55与86.32。这意味着接近90的漂亮成绩不能直接当作零延迟报警精度。
历史窗口本身可以只用当前及过去姿态,但把窗口分数回填过去帧会引入未来信息;把分数放在窗口中心也意味着相对被标记时刻的等待。时间高斯平滑若使用双侧邻域同样需要未来样本。本文没有把“Online”这个列名当成完整流式部署证明:实际复现必须记录窗口对齐、滤波是否单侧及总报警延迟,不能只报告模型前向毫秒数。
运行时表S10在GTX1080上,对已获得的50人姿态批处理耗时0.97毫秒,约1026 FPS;100人为1.62毫秒、约618 FPS。这是评分模块成本,不包含视频解码、姿态提取与跟踪,不能宣传成摄像头输入到报警的端到端速度。能量前向确实比逐次扩散生成简单,但完整系统是否实时仍取决于上游。
迁移与失败边界:人体模型不能代替场景理解
跨数据集表S8中,ShanghaiTech训练迁到UBnormal为82.4,而UBnormal本域为90.6;反向迁移到ShanghaiTech为77.2,本域86.3。这些补充配置不与20次主表混算,但方向清楚:学习到的正常密度仍受场景分布影响,不能称作域不变表示。
MSAD补充实验也提醒我们人体相关筛选会改变题目:完整集Online平滑仅59.6,人体相关版本随筛选或重标记规则变为74.1或71.6。不能把不同“HR”定义的结果直接排一个榜。放下包、物体交换或其他主要由物体决定的异常,可能在骨架上几乎没有变化;独立评分每个人也难以完整表示多人关系。
作者展示了跌倒时姿态丢失等漏检,以及倒退行走被判异常的误报。后者揭示正常密度与语义正常并不等价:训练很少出现的动作可能仍是合法正常行为。本文额外推断的是,置信度降权和PCA截断会与这些长尾情况交互,需要按遮挡、尺度和罕见正常动作分组评估;现有结果没有证明这些风险已解决。
读完之后该做什么
一个合理复现顺序是先固定姿态提取与数据切分,验证原坐标长窗口退化,再加入PCA、白化与置信度;随后单独对比无平滑、单侧平滑和离线平滑,并记录报警延迟。最后才比较能量网络规模,而不是一开始扩大模型。
STEP值得借鉴的不是某个90分数字,而是把表示几何、噪声训练和评分协议一起审查的方法。它证明轻量姿态能量模型有竞争力,但并未证明骨架足够表达所有异常,也未证明离线高分自然转换为可靠在线告警。
还有一项部署前必须单独补上的验证是阈值。AUROC比较排序,不直接告诉我们每小时会误报多少次;换一台摄像头后,即使排序大体保留,能量分布与置信度也可能改变。应在不接触目标测试异常标签的条件下设置正常分位阈值,再报告事件召回、误报次数与首次报警时间。论文的高AUROC不是这些操作指标已经达标的证据。
来源与许可
论文及版本、完整正文与补充材料,首次提交2026年8月20日,CC BY 4.0。图1、表2、补充表S7均取自该版本,保留作者与许可;本文核对正文和补充实验,未独立运行代码。
必要前作:MULDE原论文,用于核对多尺度能量、分数匹配及GMM汇总的来源,不将其不同输入设置直接当作STEP的公平组件消融。