第 3 页
共 3 页,按发布时间倒序排列。
-
 视频异常检测
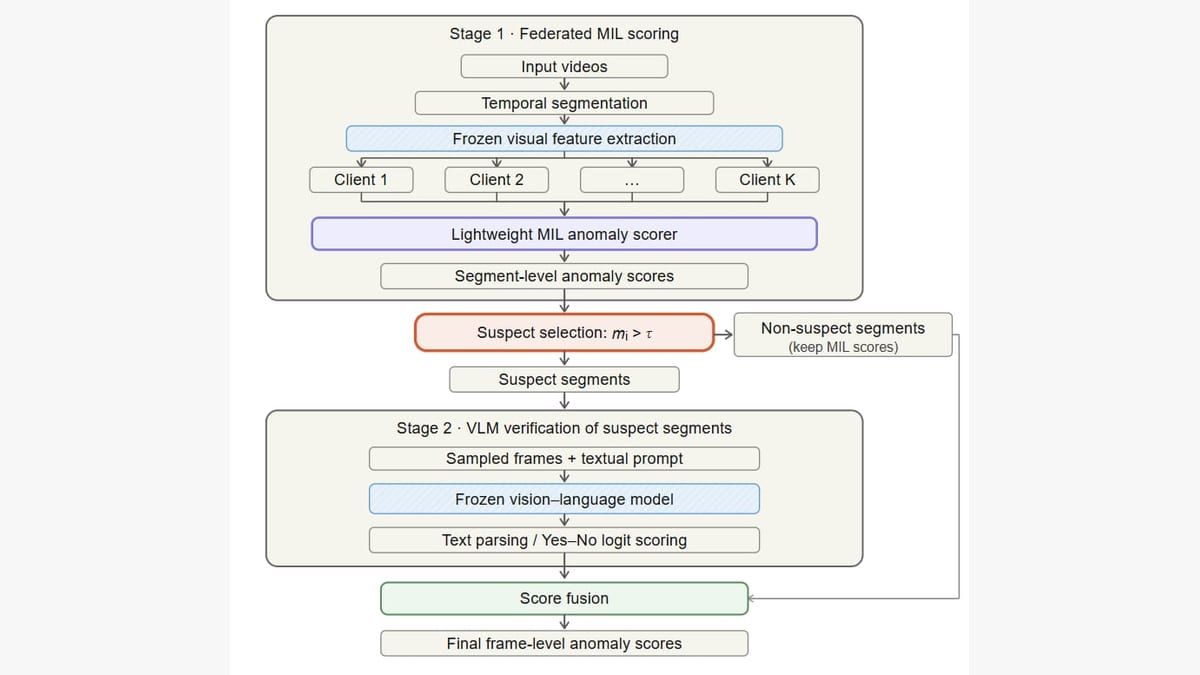
Parser-Free 精读:联邦检测之后,为什么不再解析大模型的回答?
精读联邦MIL与冻结VLM级联,核对Yes/No似然接口、AUC与AP差异、提示和时序后处理的影响,并区分片段因果、集中验证与端到端在线部署。
-
 视频异常检测
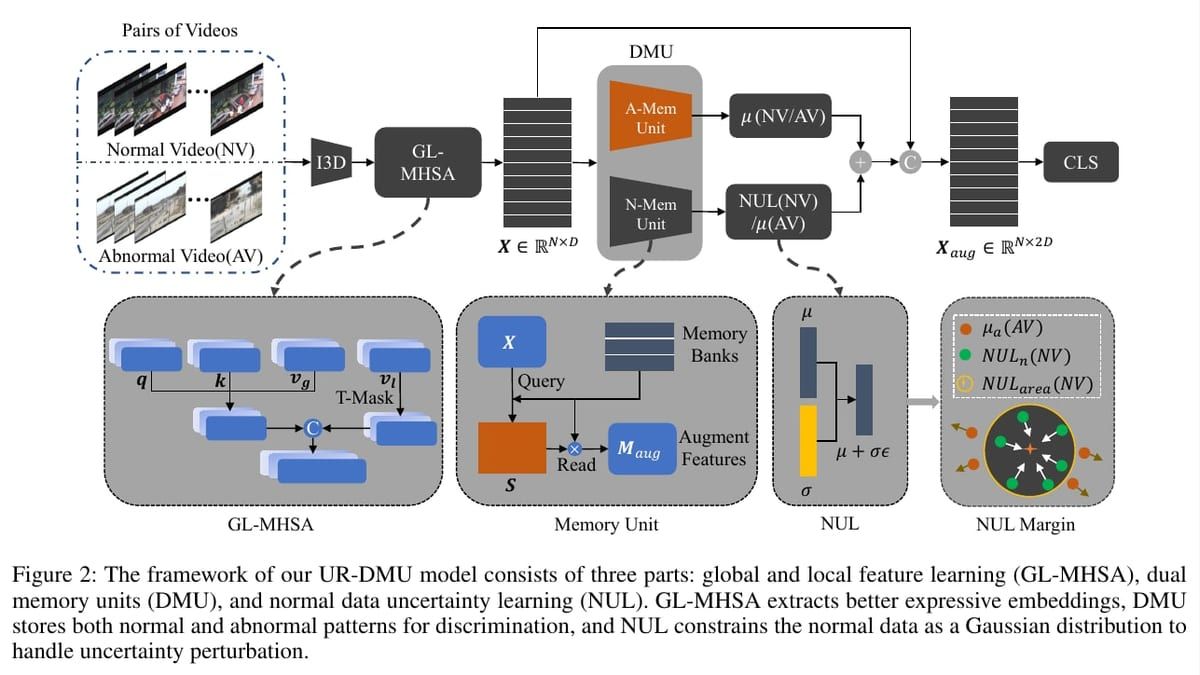
UR-DMU精读:双记忆提高了排序,为什么误报不一定更低?
拆解UR-DMU的双记忆、两种top-k和正常潜在分布,核对主结果、误报反例及官方代码中的PR积分和幅值损失差异,明确离线推理与部署边界。
-
 视频异常检测
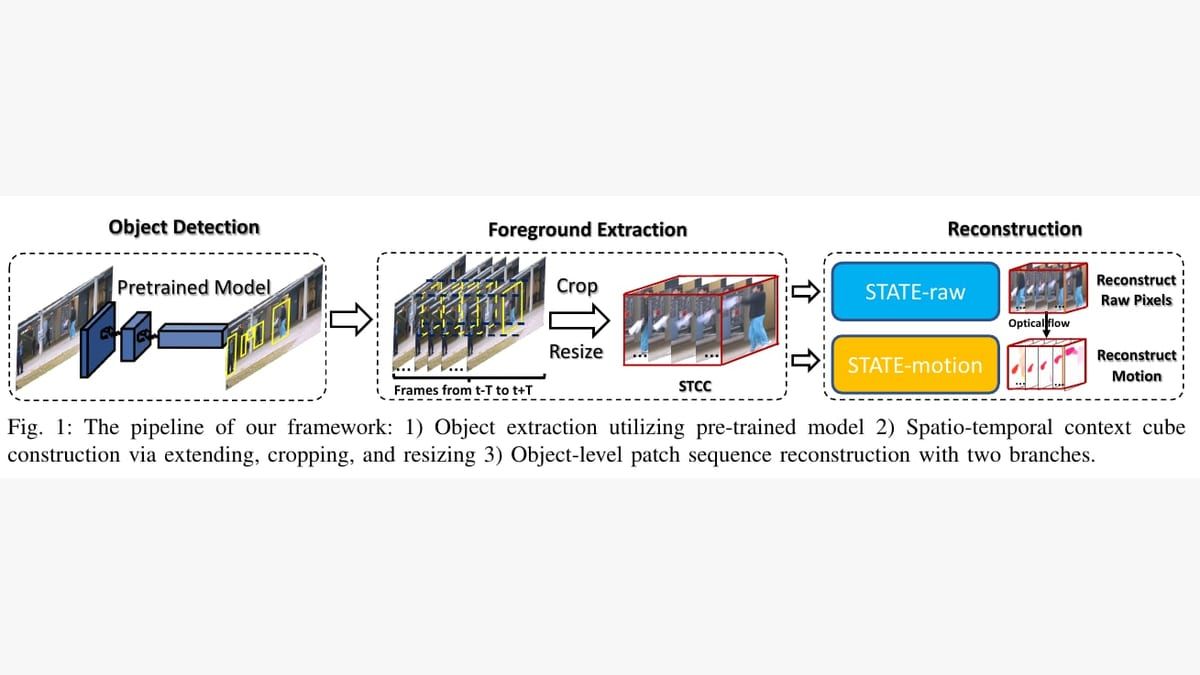
STATE 精读:降低测试重建误差,为什么反而能发现异常?
拆解 STATE 的对象级时序重建与测试输入扰动,核对两数据集增益来源、外观与光流目标差异,指出未来帧、系统成本和缺失控制实验的证据边界。
-
 视频异常检测
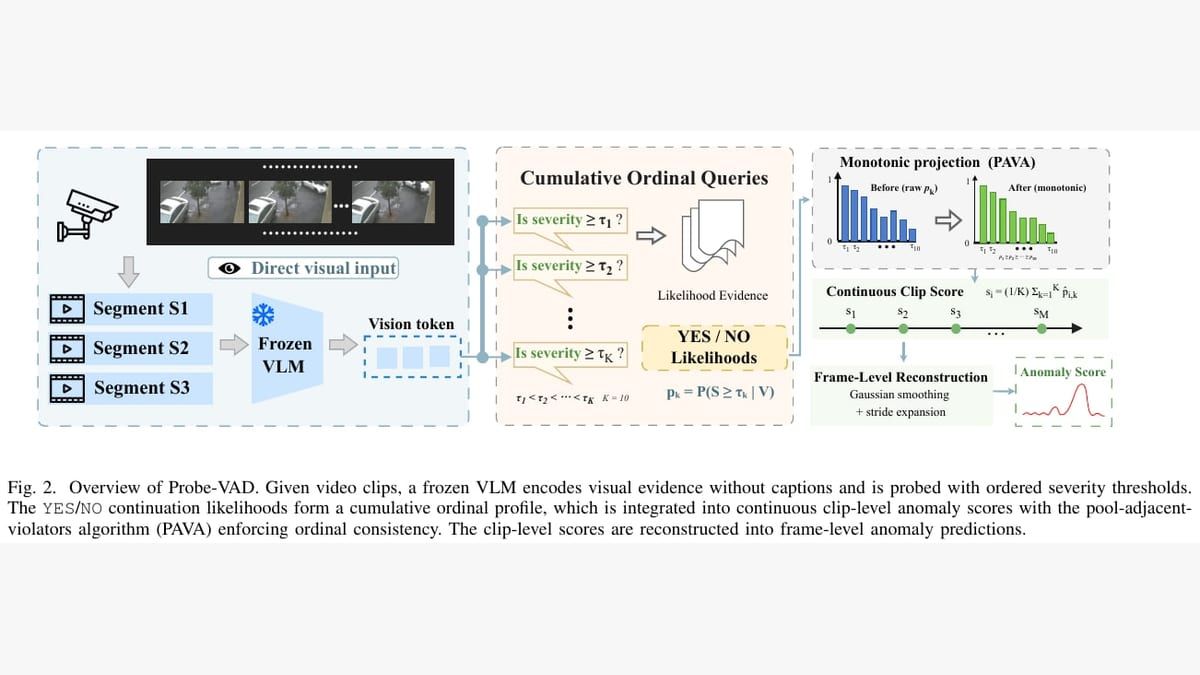
Probe-VAD 精读:似然带来提升,为什么 PAVA 不改变排名?
精读 Probe-VAD 的冻结 VLM 序数似然接口,拆开解码与二元提问的收益,核对 PAVA 保均值、主结果及消融,并指出 AP/PR-AUC 口径和非因果窗口的复现边界。
-
 视频异常检测
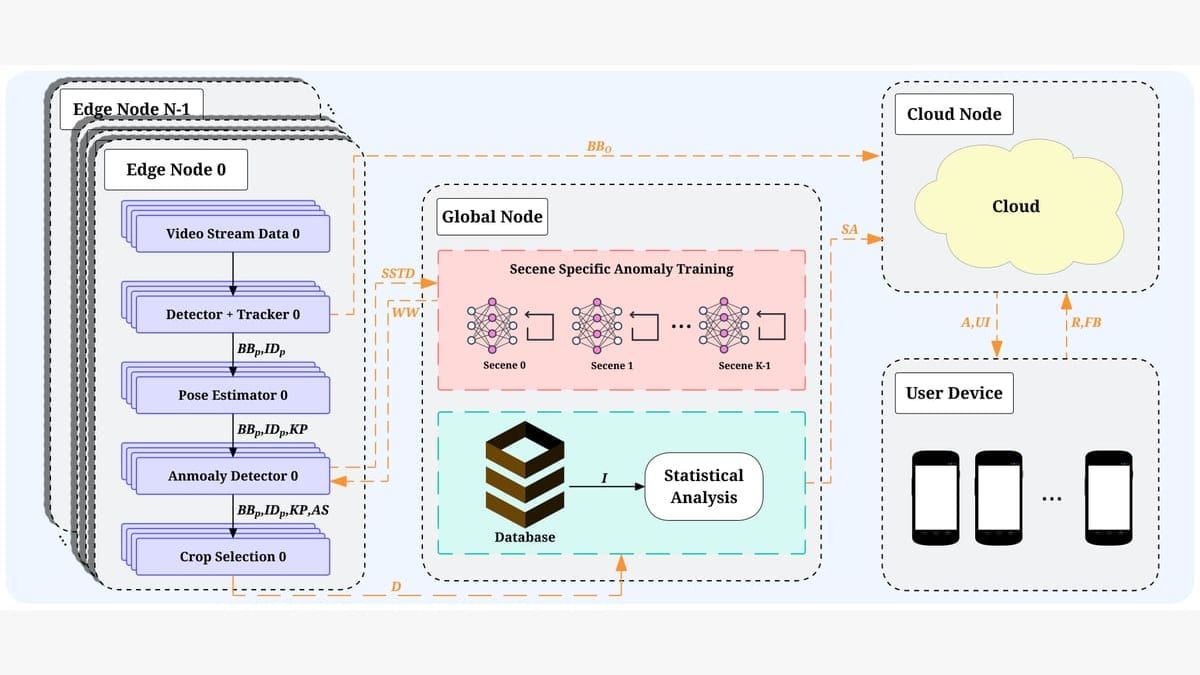
YUTELA 精读:31 路摄像头的部署证据,不能替代准确率证明
精读 YUTELA 的多站点视频异常检测系统:拆解共享流水线、按相机重训和集中适应,核对吞吐、170 小时部署与告警延迟,区分运行闭环证据和尚未验证的检测准确率收益。
-
 视频异常检测
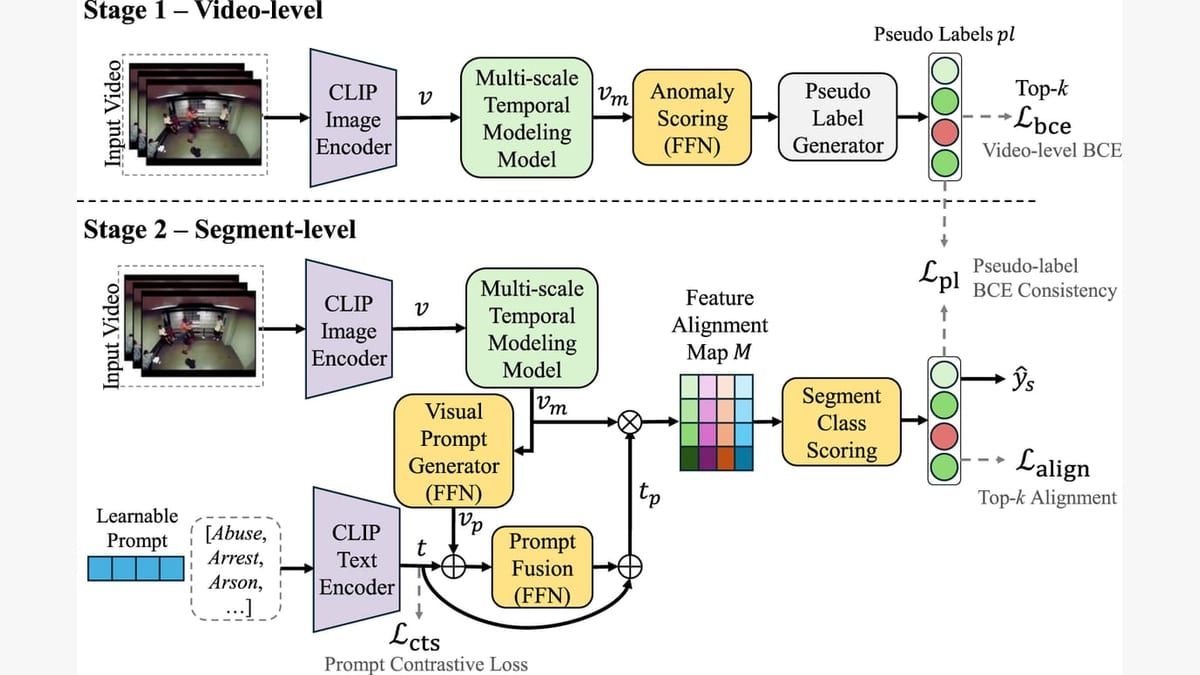
两阶段伪标签精读:定位收益从哪里来,证据又到哪里为止?
精读10月27日刊发的两阶段弱监督VAD论文,拆解CLIP、时序图建模与软标签精炼,核对AUC与定位mAP、消融及监督口径疑点。
-
 视频异常检测
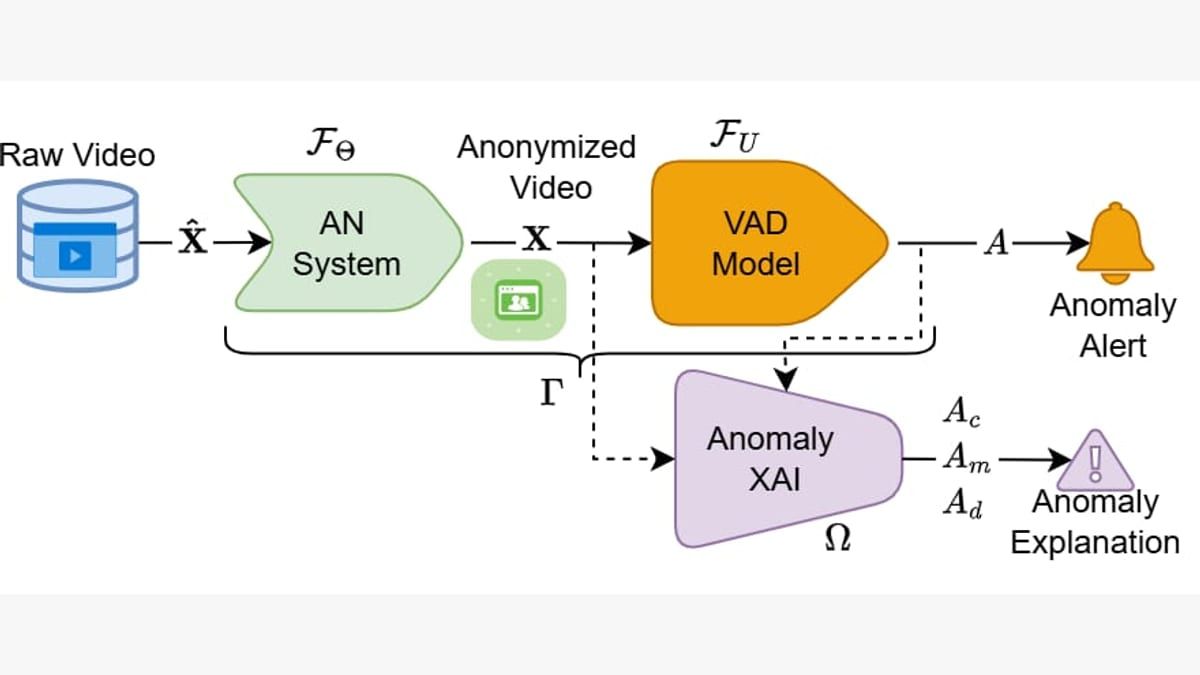
XAVAD短评:解释了异常,还是解释了文本匹配?
围绕匿名化监控视频的解释边界,核对XAVAD的图块聚焦机制、定位消融和指标协议,区分可视化线索与检测器依据,提出误报告警的验证问题。
-
 视频异常检测
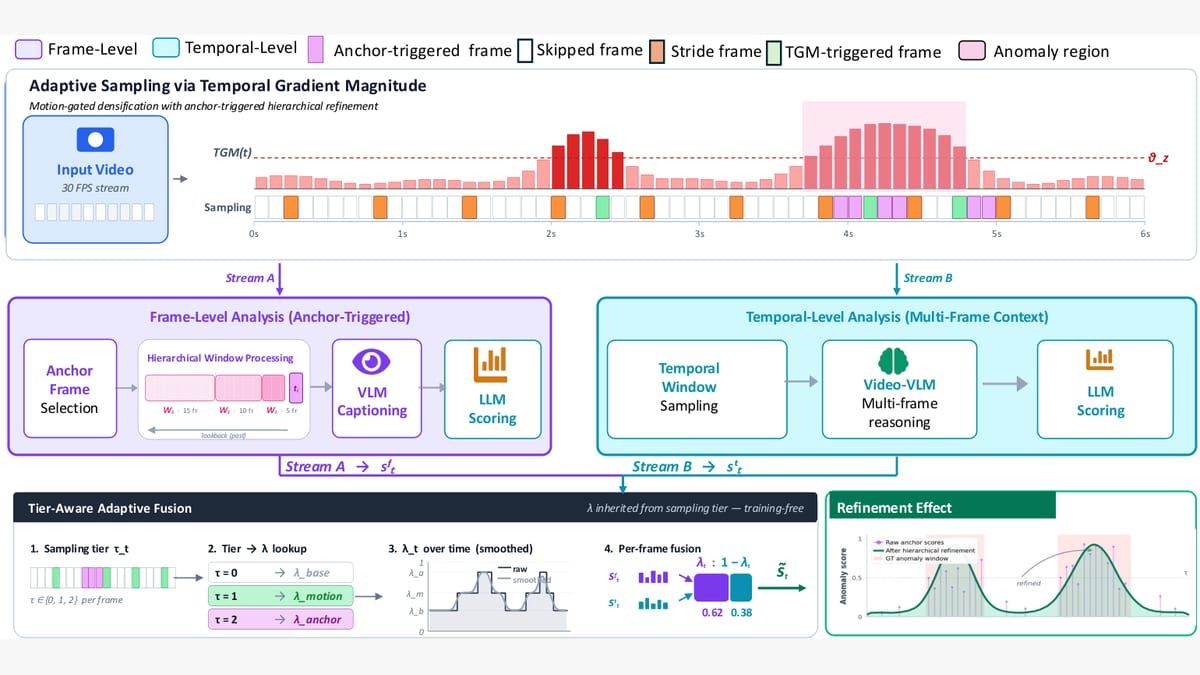
MoG-VLM比较精读:把“多想一次”与“多看几帧”分开
以MoG-VLM为中心,对照LAVAD和Unified-reasoning的计算投入位置,结合组件与补充采样实验,分析观察、推理和评分的贡献,区分作者局限、预算匹配与在线响应条件。
-
 视频异常检测
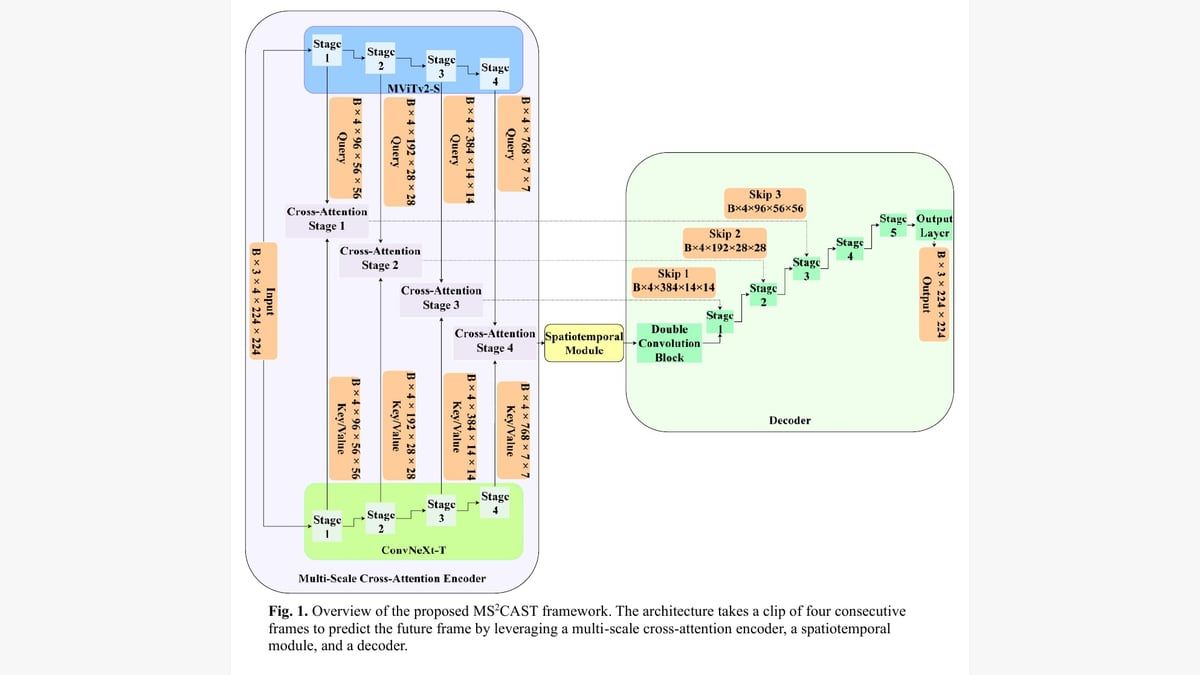
MS2CAST:预测得更好,为什么未必检测得更好?
结合预测基线、SwinLSTM与VMRNN原始工作,沿MS2CAST完整流程分析模块来源、配置取舍、噪声证据及效率边界,区分预测质量、异常检测效果与在线报警条件。